
Enterprise KI-Modelle im Architekturvergleich: Frontier-APIs versus Open-Weights
Executive Summary
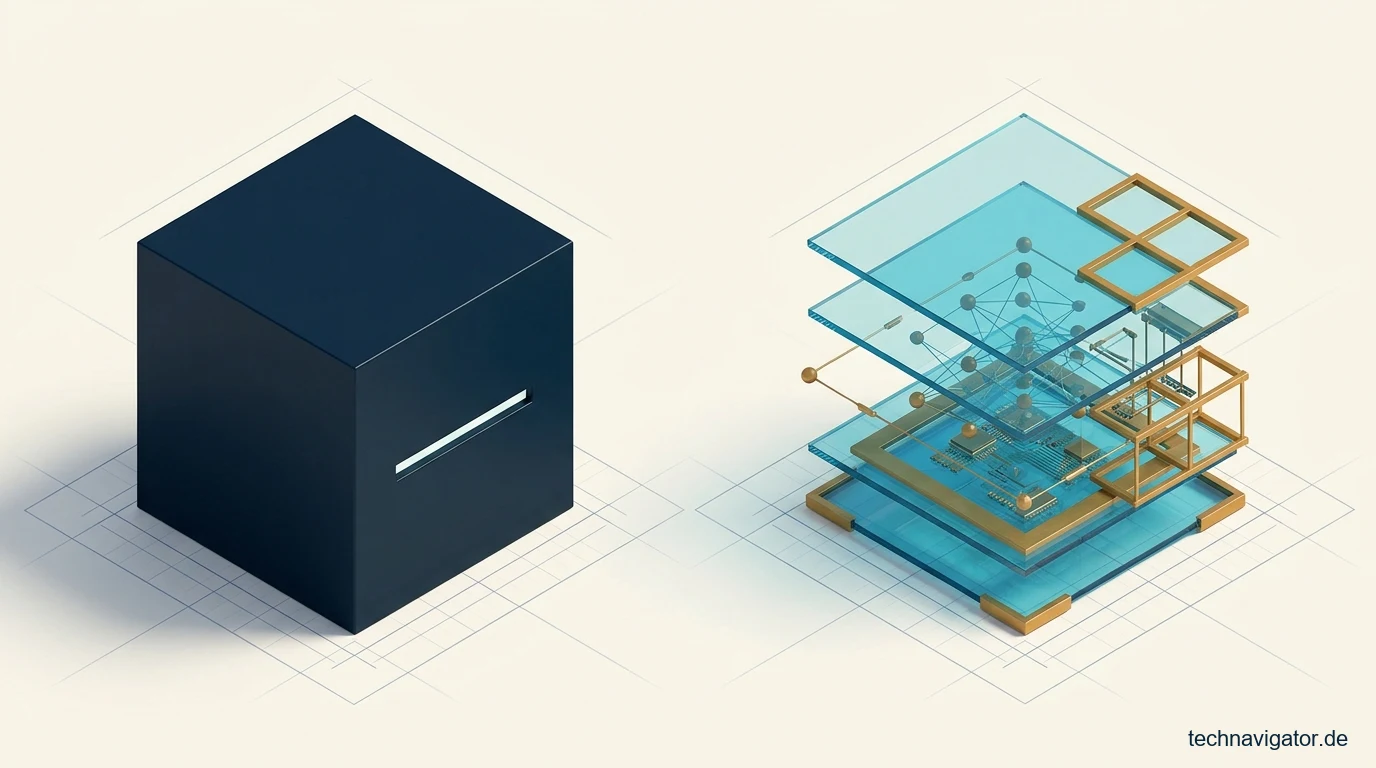
- ✓Bifurkation der Modell-Landschaft: Während proprietäre US-Frontier-APIs wie OpenAI GPT-4o, o3, Anthropic Claude 3.7 Sonnet und Google Gemini 2.5 Pro bei Spitzen-Reasoning führen, erreichen Open-Weights-Modelle wie Meta Llama 3.3 70B, Mistral Large 2, Qwen 2.5 72B und DeepSeek-R1 bei 80 Prozent aller Enterprise-Workloads Parität.
- ✓Mixture-of-Experts (MoE) senkt Inferenzkosten: Durch spärliche Aktivierung (Sparse Activation) berechnen MoE-Architekturen pro Token nur einen Bruchteil der Gesamtparameter, was den VRAM-Durchsatz auf lokalen GPU-Clustern vervielfacht.
- ✓Schutz vor API-Drift und Datenabfluss: Selbstgehostete Open-Weights-Modelle garantieren kryptografisches Version-Pinning, vollständige Gewichts-Auditierbarkeit gemäß EU AI Act** und strikte Zero-Data-Egress-Isolation im eigenen Rechenzentrum.
- ✓Über 60 Prozent TCO*-Vorteil durch Dual-Track-Routing: Ein hybrides Portfolio über standardisierte vLLM-Endpunkte verarbeitet 80 Prozent der Grundlast lokal auf Open-Weights und delegiert lediglich anonymisierte Spitzenlasten an externe APIs.
In den vergangenen vierundzwanzig Monaten hat sich die Bereitstellung großer Sprach- und Reasoning-Modelle in europäischen Unternehmen von vereinzelten Fachbereichs-Experimenten zu einer geschäftskritischen Infrastrukturfrage entwickelt. Wo anfangs ein einfacher API-Schlüssel eines US-Hyperscalers genügte, um erste Prototypen für die Dokumentenanalyse oder den Kundenservice bereitzustellen, stoßen diese Konstrukte im produktiven Großbetrieb schnell an wirtschaftliche und regulatorische Grenzen.
Mit jedem zusätzlichen Geschäftsprozess, der auf generative oder diskriminative KI-Modelle zugreift, wächst das monatliche Token-Volumen exponentiell an. Gleichzeitig verschärfen Aufsichtsbehörden, Datenschutzbeauftragte und Wirtschaftsprüfer ihre Anforderungen an die Nachvollziehbarkeit automatisierter Entscheidungen. Wer vertrauliche Konstruktionsdaten, Patientenakten oder Kreditunterlagen ungefiltert über transatlantische Programmierschnittstellen leitet, riskiert empfindliche Sanktionen und den Verlust geistigen Eigentums.
Für den Chief Information Officer (CIO) und die Enterprise-Architektur entsteht daraus die Pflicht, KI-Modelle nicht länger als austauschbare Cloud-Dienste, sondern als strategische Infrastruktur-Schicht zu klassifizieren. Dieser Leitfaden liefert die architektonische Taxonomie für den Vergleich geschlossener Frontier-APIs mit quelloffenen Open-Weights-Modellen und zeigt den Weg zu einem resilienten, hybriden Modell-Portfolio.
Architektonische Taxonomie für den CIO: Geschlossene Frontier-APIs versus souveräne Open-Weights
Auf der obersten Ebene der Unternehmens-IT teilt sich der Markt für moderne Foundation-Modelle in zwei fundamental unterschiedliche Bereitstellungsparadigmen. Auf der einen Seite stehen proprietäre US-Frontier-APIs wie OpenAI GPT-4o und die Reasoning-Reihe o3, Anthropic Claude 3.7 Sonnet sowie Google Gemini 2.5 Pro. Diese Systeme werden ausschließlich in den Rechenzentren ihrer Hersteller betrieben und lassen sich lediglich über nutzungsbasierte Mietschnittstellen ansprechen.
Ihre technische Stärke liegt in der enormen Parameterdichte, extrem großen Kontextfenstern von bis zu zwei Millionen Tokens und einer hochgradig optimierten Werkzeugnutzung für mehrstufige Agenten-Workflows. Der Preis für diese Spitzenleistung besteht jedoch im vollständigen Verzicht auf Einblick in die Modellgewichte, die Trainingsdaten-Kuratie und die unterliegenden System-Filter, die der Anbieter jederzeit einseitig anpassen kann.
Auf der anderen Seite hat sich eine hochperformante Klasse frei verfügbarer Open-Weights-Modelle etabliert, deren trainierte Gewichtungsmatrizen als Binärdateien im SafeTensors-Format heruntergeladen und vollständig autark betrieben werden können. Zu den führenden Vertretern im Enterprise-Segment zählen Meta Llama 3.3 70B, die europäischen Referenzmodelle Mistral Large 2 und Mistral Small 3, Alibaba Qwen 2.5 72B sowie das Reasoning-Modell DeepSeek-R1.
Im operativen Rechenzentrumsalltag hat sich die qualitative Lücke zwischen beiden Welten drastisch verkleinert. Für klassische Unternehmensaufgaben wie Retrieval-Augmented Generation (RAG), juristische Vertragsprüfung, strukturierte JSON-Datenextraktion, Zusammenfassungen und interne Code-Assistenz liefern moderne 70-Milliarden-Parameter-Modelle im eigenen Cluster Ergebnisse auf dem Niveau kommerzieller Cloud-Schnittstellen, ohne dass ein einziges Byte das Firmennetzwerk verlässt.
Architektonischer Blindspot: Stille Modell-Degradierung (API-Drift) und erzwungene Endpunkt-Abschaltung
Wer produktive Fachverfahren fest an proprietäre Cloud-APIs koppelt, unterschätzt oft das Risiko stiller Gewichts-Updates und kurzfristiger Endpunkt-Abkündigungen durch den Hersteller. Ändert der Cloud-Anbieter im Hintergrund die Quantisierung oder Sicherheits-Gewichtung eines Endpunkts, brechen fein kalibrierte JSON-Extraktions-Pipelines und deterministische Prüfprozesse im laufenden Betrieb zusammen, ohne dass das eigene Betriebsteam das Update verhindern oder auf den exakten Vorzustand zurückrollen kann.
Um diese Risiken präzise zu bewerten, müssen Architekten die Stärken einzelner Modellfamilien im Detail kennen. Eine tiefgehende Analyse der hybriden Reasoning-Mechanismen und Sicherheitsgrenzen kommerzieller Spitzenmodelle bietet unser Fachbeitrag zu Anthropic Claude AI in der Enterprise-Architektur, während wir die mathematischen Grundlagen offener Reasoning-Ketten im Dossier zu DeepSeek-R1 und offenen Reasoning-Modellen untersuchen.
Ergänzende Architektur-Analysen und technische Entscheidungsmatrizen für Ihre IT-Planung finden Sie in unseren weiterführenden Leitartikeln zu Enterprise KI-Strategie im Enterprise-Einsatz sowie zu ElevenLabs Voice-AI im Enterprise-Einsatz.
Technischer Deep-Dive: Dense Transformer versus Mixture-of-Experts (MoE) und vLLM-Orchestrierung
Für die Dimensionierung eigener KI-Infrastrukturen im Rechenzentrum reicht der Blick auf die bloße Gesamtanzahl der Modellparameter nicht aus. Entscheidend für Speicherdurchsatz, Antwortlatenz (Time-to-First-Token) und Energiebedarf ist die interne Netzwerktopologie des Modells, wobei sich heute klassische dichte Architekturen (Dense Transformers) und spärlich aktivierte Mixture-of-Experts-Systeme (MoE) gegenüberstehen.
Aktive Parameter-Effizienz, KV-Cache-Mathematik und FP8-Quantisierung
In einem dichten Transformer-Modell wie Meta Llama 3.3 70B oder Qwen 2.5 72B wird bei der Erzeugung jedes einzelnen Ausgabe-Tokens das gesamte neuronale Netz mit allen 70 beziehungsweise 72 Milliarden Parametern durchlaufen. Das garantiert eine sehr hohe Konsistenz über unterschiedlichste Wissensdomänen hinweg, bindet jedoch pro Token die volle Speicherbandbreite der unterliegenden Grafikkarten.
Im Gegensatz dazu zerlegt eine Mixture-of-Experts-Architektur wie DeepSeek-R1 (671 Milliarden Gesamtparameter) oder Mixtral die Feed-Forward-Schichten in zahlreiche spezialisierte Teilnetze. Ein vorgeschaltetes Gating-Netzwerk (Router) entscheidet für jedes Token dynamisch, welche Experten-Teilnetze aktiviert werden, sodass bei DeepSeek-R1 pro Berechnungsschritt lediglich 37 Milliarden aktive Parameter tatsächlich Rechenzeit und Speicherbandbreite beanspruchen.
Für den Infrastruktur-Architekten ergibt sich daraus ein präzises Sizing-Kriterium: Während die Gesamtanzahl der Parameter bestimmt, wie viel Grafikspeicher (VRAM) statisch vorgehalten werden muss, determiniert die Zahl der aktiven Parameter die Generierungsgeschwindigkeit in Tokens pro Sekunde. Ergänzt durch verlustarme FP8- oder AWQ-4-Bit-Quantisierung lässt sich ein 70B-Modell heute bereits auf zwei gekoppelten Enterprise-GPUs mit hoher Parallelität betreiben.
Besondere Beachtung verdient dabei die Dimensionierung des Key-Value-Caches (KV-Cache), der bei langen Eingabekontexten und vielen gleichzeitigen Nutzern schnell mehr VRAM belegt als die Modellgewichte selbst. Moderne Inferenz-Server lösen dieses Problem durch PagedAttention und Grouped-Query Attention (GQA), wodurch der Speicherbedarf des Kontext-Caches um über 70 Prozent sinkt und Fragmentierung im Grafikspeicher vermieden wird.
„Wahre KI-Souveränität entsteht nicht durch den Verzicht auf Spitzenmodelle, sondern durch architektonische Entkopplung: Wer Open-Weights über standardisierte vLLM-Gateways als Grundlast-Fundament betreibt, degradiert externe Cloud-APIs zu jederzeit austauschbaren Spezial-Komponenten.“
Wie sich die Meta-Modellfamilie konkret auf eigener Hardware mit minimaler Latenz produktiv setzen lässt, zeigen wir in unserem Praxisleitfaden zu Meta Llama im Enterprise-Eigenbetrieb. Dort finden Infrastruktur-Teams auch detaillierte Referenzwerte für die Kopplung über NVLink und InfiniBand.
Version-Pinning, Gewichts-Auditierbarkeit und das Dual-Track-Portfolio via vLLM
Neben der reinen Recheneffizienz bieten Open-Weights-Modelle drei architektonische Garantien, die kein geschlossener Cloud-Dienst vertraglich zusichern kann. Erstens ermöglicht das lokale Vorhalten der unveränderbaren SafeTensors-Dateien ein kryptografisches Model-Version-Pinning: Ein einmal abgenommenes und durch die interne Revision geprüftes Sprachmodell liefert auch nach drei Jahren noch exakt dasselbe Systemverhalten ohne überraschende API-Drift.
Zweitens erlaubt der direkte Zugriff auf die Modellgewichte ein tiefgreifendes Sicherheits- und Bias-Audit sowie domänenspezifisches Fine-Tuning mittels Low-Rank Adaptation (LoRA). Unternehmen können eigene Fachterminologien, interne Programmierrichtlinien oder regulatorische Schwellenwerte direkt in kompakte Adapter-Schichten einbacken, die zur Laufzeit dynamisch in den Inferenz-Server geladen werden.
Drittens bildet eine OpenAI-kompatible Inferenz-Engine wie vLLM oder TGI (Text Generation Inference) in Kombination mit einem zentralen KI-Gateway die Brücke zu einer hybriden Dual-Track-Architektur. Applikationen im Unternehmen sprechen ausschließlich einen internen REST-Endpunkt an, der anhand von Datenklassifizierung und Aufgabenkomplexität entscheidet, ob der Aufruf lokal von Llama 3.3 70B bzw. Mistral Small 3 verarbeitet oder anonymisiert an eine Frontier-API weitergeleitet wird.
Wer dieses Architekturmuster mit einer lokal abgesicherten Vektordatenbank für Unternehmenswissen verbindet, schließt das Risiko ungewollter Datenabflüsse vollständig aus. Die exakte Referenzarchitektur für solche Wissens-Pipelines beschreiben wir im Leitfaden für lokale LLMs und Enterprise-RAG mit voller Datensouveränität.
Architektur- und Betriebsvergleich: Proprietäre Frontier-APIs versus Open-Weights-Stack
Für die strategische Portfoliosteuerung im IT-Lenkungsausschuss müssen Leistungsfähigkeit, Datenschutz, Betriebskosten und regulatorische Nachweispflichten systematisch gegeneinander abgewogen werden. Eine einseitige Festlegung auf reine Public-Cloud-Schnittstellen führt ab einer kritischen Nutzungsdichte ebenso in die Sackgasse wie der Versuch, hochkomplexe Spezialrecherchen auf unterdimensionierter Lokal-Hardware abzubilden.
Die nachfolgende Bloomberg-Radar-Matrix stellt geschlossene US-Frontier-APIs und einen selbst- bzw. europäisch gehosteten Open-Weights-Stack auf Basis von vLLM anhand der fünf zentralen CIO-Entscheidungsdimensionen gegenüber:
| Architektur- & Governance-Dimension | Proprietäre US-Frontier-APIs (GPT-4o / Claude 3.7 / Gemini 2.5) | Souveräner Open-Weights-Stack (Llama 3.3 / Mistral / Qwen / DeepSeek) | CIO-Bewertung |
|---|---|---|---|
| 1. Datenhoheit & Egress-Kontrolle | Zwingender Datenabfluss an externe Cloud-Endpunkte unter US-Jurisdiktion (CLOUD Act); Verarbeitung im Klartext außerhalb des eigenen Perimeters. | Vollständiger Zero-Data-Egress im eigenen Rechenzentrum oder Air-Gapped-Cluster; keinerlei Telemetrie- oder Prompt-Abfluss an Dritte. |
Zero Data Egress100 % Perimeter-Kontrolle
|
| 2. Modell-Stabilität & Version-Pinning | Hohes Risiko stiller Gewichts-Updates (API-Drift) und erzwungener Modell-Abkündigungen innerhalb weniger Monate. | Kryptografisches Pinning der SafeTensors-Gewichte; deterministisches Verhalten über Jahre hinweg für geprüfte Fachprozesse. |
Kein API-DriftRevisionssicheres Pinning
|
| 3. Architektur-Effizienz (Dense vs. MoE) | Intransparente Blackbox-Architektur; Abrechnung erfolgt strikt pro Eingabe- und Ausgabe-Token unabhängig vom internen Rechenaufwand. | Freie Wahl zwischen kompakten Dense-Modellen (8B bis 72B) und spärlichen MoE-Systemen mit maximalem Durchsatz via vLLM und FP8. |
Hoher DurchsatzPlanbare Fixkosten-Basis
|
| 4. Spitzen-Reasoning & Multimodalität | Marktführend bei hochkomplexem Multi-Step-Reasoning, nativer Audio-/Video-Verarbeitung und extrem großen Kontextfenstern. | Parität bei 80 % aller Enterprise-Aufgaben (RAG, Extraktion, Coding); für 20 % hochspezialisierte Randfälle über Hybrid-Routing ergänzbar. |
80/20 Hybrid-IdealDual-Track über KI-Gateway
|
| 5. EU AI Act & Auditierbarkeit | Eingeschränkte Nachweisführung für Hochrisiko-Systeme, da Trainingskorpora, System-Prompts und Sicherheitsfilter nicht einsehbar sind. | Volle Auditierbarkeit der Modellgewichte, LoRA-Adapter und Guardrails für Konformitätsbewertungen nach EU AI Act und BSI-Standards. |
Audit-konformVolle Gewichts-Transparenz
|
Der direkte Vergleich verdeutlicht, warum führende europäische Industrie-, Finanz- und Gesundheitsunternehmen von einer reinen Single-Vendor-API-Strategie abrücken. Während Frontier-APIs als Innovationsbeschleuniger für unkritische Daten dienen, entsteht die eigentliche Wertschöpfung bei vertraulichen Kerngeschäftsprozessen erst auf einer kontrollierbaren Open-Weights-Plattform.
Durch die Standardisierung auf das OpenAI-API-Protokoll innerhalb von vLLM bleibt die Anwendungsentwicklung von dieser Infrastruktur-Entscheidung vollständig verschont. Entwicklerteams programmieren gegen eine einheitliche interne Schnittstelle, während das Architektur-Team die unterliegenden Modelle je nach Reifegrad, Lizenzmodell und Hardware-Auslastung unterbrechungsfrei austauschen kann.
Vollkostenrechnung über 60 Monate: Wann der Token-Zinseszins externe APIs unrentabel macht
Aus Sicht des Finanzvorstands (CFO) gleicht die Abrechnung externer Frontier-APIs einer variablen Verbrauchssteuer auf die digitale Produktivität des Unternehmens. Solange lediglich wenige Dutzend Mitarbeitende gelegentlich Fragen an einen Chatbot richten, wirken nutzungsbasierte Token-Preise von drei bis fünfzehn US-Dollar pro Million Tokens wirtschaftlich attraktiv, weil keinerlei Vorabinvestitionen (CAPEX) anfallen.
Dieses Bild kippt jedoch radikal, sobald KI-Modelle tief in automatisierte Hintergrundprozesse, Enterprise-RAG-Pipelines mit umfangreichen Dokumenten-Kontexten und mehrstufige Agenten-Schleifen integriert werden. In einer repräsentativen Umgebung mit 2.500 Wissensarbeitenden und automatisierter Dokumentenverarbeitung entstehen im produktiven Ausbau rasch 150 bis 200 Milliarden verarbeitete Eingabe- und Ausgabe-Tokens pro Monat.
Wird dieses Volumen vollständig über kommerzielle Premium-APIs abgewickelt, inklusive der Zuschläge für Enterprise-Datenschutzvereinbarungen, Provisioned-Throughput-Garantien und Netzwerk-Egress, summieren sich die laufenden Ausgaben auf durchschnittlich 38.000 bis 45.000 Euro pro Monat. Über einen Betrachtungszeitraum von 60 Monaten (fünf Jahre) fließt damit ein Budget von rund 2,52 Millionen Euro ab, ohne dass dem Unternehmen am Ende eigene Infrastruktur oder geistiges Eigentum an angepassten Modellen verbleibt.
Setzt dasselbe Unternehmen hingegen auf eine hybride Dual-Track-Architektur, bei der zwei dedizierte Inferenz-Knoten (ausgestattet mit jeweils vier Enterprise-GPUs der H200- oder L40S-Klasse) 80 Prozent der Grundlast über quantisierte Open-Weights-Modelle wie Llama 3.3 70B und Mistral Small 3 abdecken, verändert sich die Kostenstruktur grundlegend.
Inklusive Hardware-Abschreibung bzw. dediziertem GPU-Colocation-Mietpreis, Stromverbrauch, Kühlung, vLLM-Betriebsautomatisierung und einem verbleibenden 20-Prozent-API-Budget für anonymisierte Spitzenlasten liegen die Fünfjahresgesamtkosten bei rund 940.000 Euro. Das Unternehmen erzielt eine kumulierte Netto-Ersparnis von 1,58 Millionen Euro (über 62 Prozent TCO-Reduktion) und erreicht den Break-even-Punkt bereits im vierzehnten Betriebsmonat.
Die Make-or-Buy Sourcing-Weiche und regulatorische Resilienz unter EU AI Act und DSGVO
Für die praktische Umsetzung einer souveränen oder hybriden Modell-Architektur stehen IT-Entscheidern drei klar abgegrenzte Betriebsmodelle offen. Die Auswahl richtet sich nach dem vorhandenen Know-how im Bereich Plattform-Engineering, der Sensibilität der verarbeiteten Unternehmensdaten sowie der gewünschten Grundlast-Kapazität.
Erstens (Eigenbetrieb): Organisationen mit strengsten Geheimhaltungsanforderungen, eigenen Rechenzentrumsflächen oder bestehenden Colocation-Racks betreiben dedizierte GPU-Server mit Kubernetes, vLLM und lokalen Modell-Registries in vollständiger Eigenregie. Dieses Modell bietet maximale physische Kontrolle und erlaubt den Betrieb komplett isolierter Air-Gapped-Umgebungen für Forschung, Verteidigung, Finanzkernprozesse oder kritische Infrastrukturen.
Zweitens (Co-Managed): Gehobene Mittelständler mieten dedizierte Bare-Metal-GPU-Instanzen bei zertifizierten europäischen Cloud-Anbietern nach C5-Standard und orchestrieren darauf ihren eigenen Open-Weights-Software-Stack mittels GitOps, Helm-Charts und zentralem API-Gateway. Das Infrastruktur-Team behält die volle Hoheit über die SafeTensors-Gewichte, LoRA-Adapter und Verschlüsselungsschlüssel, während Hardware-Wartung und RZ-Betrieb ausgelagert sind.
Drittens (Managed Service): Unternehmen ohne eigenes MLOps-Team beziehen verwaltete Open-Weights-Endpunkte über souveräne europäische KI-Plattformen mit vertraglich garantierter Zero-Data-Retention und EU-Rechtsstandort. Wichtig ist hierbei die architektonische Vorgabe, dass sämtliche Aufrufe über ein unternehmenseigenes Routing-Gateway laufen, damit ein späterer Wechsel auf eigene GPU-Knoten jederzeit ohne Code-Änderung in den Fachanwendungen möglich bleibt.
Unabhängig vom gewählten Bereitstellungsweg zahlt der Einsatz dokumentierter Open-Weights-Modelle unmittelbar auf die Einhaltung der europäischen KI-Verordnung (EU AI Act, Verordnung (EU) 2024/1689) ein. Wo KI-Systeme in regulierten Bereichen wie Personalwesen, Kreditwürdigkeitsprüfung, kritischer Infrastruktur oder Medizintechnik eingesetzt werden, verlangt der Gesetzgeber eine lückenlose technische Dokumentation, Risikobewertung und menschliche Aufsicht.
Zugleich adressiert die lokale Modell-Inferenz die schärfsten Angriffsvektoren der OWASP Top 10 für Large Language Model Applications, insbesondere den Schutz vor Sensitive Information Disclosure (LLM02) und Supply Chain Vulnerabilities (LLM03). Durch deterministisches Version-Pinning, lokale Eingabe-Guardrails und strikte Mandantentrennung nach BSI IT-Grundschutz behalten Sicherheitsverantwortliche jederzeit die volle Nachweisfähigkeit gegenüber Aufsichtsbehörden.
Der 4-Phasen-Umsetzungsfahrplan: Vom ungesteuerten API-Wildwuchs zum hybriden KI-Portfolio
Der Übergang von verstreuten Cloud-API-Integrationen zu einer geordneten Dual-Track-Architektur erfordert keinen abrupten Entwicklungsstopp. Bewährt hat sich ein vierstufiges Vorgehen über sechs bis zwölf Monate, das zunächst Transparenz in den Datenfluss bringt und anschließend die Grundlast schrittweise auf souveräne Open-Weights-Instanzen überführt.
Phase 1 (Monat 1 bis 2): Use-Case-Inventur, Datenklassifizierung und zentrales KI-Gateway
Im ersten Schritt erfasst die Architekturabteilung sämtliche produktiven und geplanten KI-Anwendungsfälle inklusive ihres monatlichen Token-Verbrauchs, ihrer Latenzanforderungen und der Schutzklasse der verarbeiteten Daten. Parallel wird ein zentrales, OpenAI-kompatibles KI-Gateway (beispielsweise auf Basis von LiteLLM oder Kong AI Gateway) vor alle bestehenden Cloud-Endpunkte geschaltet, um einheitliches Logging, Kostenkontrolle und rollenbasierte Zugriffskontrolle zu erzwingen.
Phase 2 (Monat 3 bis 4): Aufbau des vLLM-Referenzclusters und Golden-Dataset-Benchmarking
Das Plattform-Team nimmt eine erste dedizierte GPU-Umgebung in Betrieb und installiert vLLM als hochperformante Serving-Schicht für ausgewählte Open-Weights-Kandidaten wie Meta Llama 3.3 70B, Mistral Small 3 und DeepSeek-R1. Anhand eines unternehmensspezifischen Prüfdatensatzes (Golden Dataset) aus realen Fachanfragen werden Antwortqualität, JSON-Schematreue und Antwortzeiten direkt gegen die bisherigen Frontier-APIs vermessen.
Phase 3 (Monat 5 bis 6): Migration der RAG-Grundlast und PII-Anonymisierung
Sämtliche Workloads mit vertraulichen Personen-, Kunden- oder Konstruktionsdaten sowie hochvolumige Standardaufgaben werden im KI-Gateway auf die lokalen Open-Weights-Endpunkte umgeroutet. Für die verbleibenden zwanzig Prozent komplexer Spezialanfragen, die weiterhin externe Frontier-APIs nutzen, aktiviert das Sicherheitsteam eine vorgeschaltete Erkennungs- und Maskierungsschicht, die personenbezogene Merkmale (PII) vor dem Verlassen des Perimeters automatisch schwärzt.
Phase 4 (Monat 7 bis 12): Domänen-Adaption mittels LoRA und kontinuierliche Modell-Governance
In der Ausbauphase optimiert das Unternehmen seine lokalen Basismodelle durch leichtgewichtige LoRA-Adapter oder gezielte Prompt-Destillation auf interne Fachterminologien und etabliert einen geregelten Lebenszyklus für Modell-Updates. Neue Open-Weights-Generationen werden zunächst in einer isolierten Staging-Umgebung gegen das Golden Dataset sowie automatisierte Red-Teaming-Filter geprüft, bevor das Version-Pinning im Produktivbetrieb kontrolliert angehoben wird.
Fünf Kontrollfragen für Vorstand und IT-Leitung zur KI-Modell-Architektur
1. Wie hoch ist unser aktueller und auf 36 Monate projizierter Token-Abfluss an externe Cloud-APIs?
Verlangen Sie vom Controlling eine vollständige Transparenz über alle Fachabteilungen hinweg, wie viele Millionen Tokens monatlich über externe Programmierschnittstellen abgerechnet werden. Erst wenn das Wachstum durch geplante RAG- und Agenten-Projekte über drei bis fünf Jahre hochgerechnet wird, zeigt sich der tatsächliche Schwellenwert, ab dem eigene oder dediziert gemietete GPU-Kapazitäten deutlich günstiger arbeiten.
2. Können wir bei unseren geschäftskritischen KI-Prozessen ein stilles Modell-Update des Herstellers technisch ausschließen?
Prüfen Sie gemeinsam mit Ihren Anwendungsarchitekten, was passiert, wenn ein externer Cloud-Anbieter ein genutztes Sprachmodell mit einer Frist von wenigen Wochen abkündigt oder dessen interne Gewichtung verändert. Für regulatorisch geprüfte oder tief in ERP- und Dokumentenprozesse integrierte Abläufe ist ein unveränderbares Version-Pinning über selbst kontrollierte Open-Weights-Dateien unverzichtbar.
3. Sind sämtliche KI-Aufrufe über ein zentrales, herstellerneutrales Gateway von den Fachanwendungen entkoppelt?
Stellen Sie sicher, dass kein Entwicklungsteam proprietäre SDKs einzelner KI-Hersteller direkt in den Quellcode geschäftskritischer Applikationen einbettet. Eine zwingende Abstraktionsschicht nach OpenAI-Schnittstellenstandard gewährleistet, dass Sie das unterliegende Sprachmodell binnen Minuten zwischen verschiedenen Open-Weights-Instanzen und externen Anbietern umschalten können.
4. Nach welchen objektiven Metriken entscheiden wir zwischen dichten Transformern, MoE-Modellen und kleinen Spezialmodellen?
Hinterfragen Sie den Reflex, jede einfache Klassifizierungs- oder Zusammenfassungsaufgabe an das jeweils größte und teuerste Universalmodell zu delegieren. In einer reifen Enterprise-Architektur übernehmen kompakte Modelle mit 8 bis 24 Milliarden Parametern oder spärlich aktivierte MoE-Systeme die schnelle Grundlast, während schwere Reasoning-Modelle ausschließlich bei echtem Bedarf aufgerufen werden.
5. Erfüllt unsere Modell-Dokumentation bereits die Nachweispflichten des EU AI Act und der internen Revision?
Klären Sie frühzeitig mit Ihrer Rechts- und Compliance-Abteilung, welche Ihrer KI-Anwendungsfälle unter die Transparenz- oder Hochrisiko-Kategorien der europäischen KI-Verordnung fallen. Wo Prüfer Einblick in System-Prompts, Schutzfilter, Versionierung und Datenflüsse verlangen, verschafft eine souveräne Open-Weights-Umgebung im eigenen Perimeter einen entscheidenden Compliance-Vorsprung.
Strategisches Fazit: Vom unkontrollierten API-Konsum zur souveränen Modell-Architektur
Die erste Welle der generativen KI im Unternehmen war geprägt vom schnellen Experimentieren über gemietete Cloud-Schnittstellen. In der nun begonnenen Phase der industriellen Skalierung entscheidet jedoch die architektonische Unabhängigkeit darüber, ob künstliche Intelligenz zum nachhaltigen Produktivitätsmotor oder zur unbeherrschbaren Kosten- und Compliance-Hypothek wird.
Der vermeintliche Zielkonflikt zwischen der Spitzenleistung geschlossener US-Frontier-Modelle und der Datensouveränität quelloffener Alternativen lässt sich durch ein sauberes Dual-Track-Design vollständig auflösen. Moderne Open-Weights-Architekturen wie Meta Llama 3.3, Mistral Large 2, Qwen 2.5 und DeepSeek-R1 bieten in Verbindung mit vLLM-Inferenz-Servern die nötige Reife, um den Großteil aller betrieblichen Arbeitslasten sicher und kosteneffizient im eigenen Perimeter zu verarbeiten.
CIOs, die heute eine herstellerneutrale Gateway-Schicht einziehen, ihre vertraulichen Wissensbestände konsequent auf souveränen Open-Weights-Modellen verankern und externe Cloud-APIs lediglich als streng reglementierte Zusatzkapazität nutzen, sichern ihrem Unternehmen dauerhafte Kostentransparenz, volle Revisionssicherheit unter dem EU AI Act und echte technologische Handlungsfreiheit.
Häufig gestellte Fragen (FAQ) zu Enterprise KI-Modellen und Open-Weights
Worin unterscheidet sich ein Open-Weights-Modell rechtlich und technisch von klassischer Open-Source-KI?
Bei einem Open-Weights-Modell veröffentlicht der Hersteller die fertig trainierten neuronalen Gewichtungsmatrizen (meist im SafeTensors-Format) zur freien lokalen Ausführung und Feinabstimmung, legt jedoch nicht zwingend den gesamten Rohdatensatz des Pre-Trainings offen. Für den Enterprise-Betrieb im eigenen Rechenzentrum reicht die Verfügbarkeit der Gewichte vollkommen aus, um Zero-Data-Egress, Version-Pinning und unabhängige Sicherheitsaudits sicherzustellen.
Welche GPU-Hardware wird benötigt, um ein 70B-Modell wie Llama 3.3 produktiv im Unternehmen zu betreiben?
In nativer 16-Bit-Präzision (FP16/BF16) belegen die Gewichte eines 70-Milliarden-Parameter-Modells rund 140 Gigabyte VRAM, wozu inklusive KV-Cache für parallele Sitzungen typischerweise zwei bis vier GPUs der Klasse NVIDIA H100, H200 oder AMD Instinct MI300X eingesetzt werden. Durch moderne FP8- oder AWQ-4-Bit-Quantisierung unter vLLM sinkt der Speicherbedarf bei vernachlässigbarem Qualitätsverlust auf unter 45 Gigabyte plus Kontextpuffer.
Warum sind Mixture-of-Experts-Modelle (MoE) für den Rechenzentrumsbetrieb oft wirtschaftlicher als dichte Modelle?
Während ein dichtes Transformer-Modell für jedes generierte Wort sämtliche Parameter berechnen muss, aktiviert eine MoE-Architektur über einen internen Router pro Token nur wenige spezialisierte Teilnetze (Experten). Dadurch kombiniert ein MoE-System das breite Fachwissen eines sehr großen Modells mit dem geringen Rechen- und Latenzaufwand eines deutlich kleineren Netzes.
Wie lässt sich verhindern, dass Fachanwendungen bei einem Modellwechsel aufwendig umprogrammiert werden müssen?
Der Schlüssel liegt im Einsatz einer zentralen Inferenz- und Gateway-Schicht wie vLLM in Kombination mit LiteLLM oder einem Enterprise-API-Gateway. Da diese Komponenten intern exakt die standardisierte OpenAI-REST-Spezifikation bereitstellen, kann das Infrastruktur-Team im Hintergrund beliebig zwischen Llama, Mistral, Qwen oder externen Cloud-Modellen wechseln, ohne den Anwendungscode anzufassen.
Reicht ein Zero-Data-Retention-Vertrag mit einem US-Hyperscaler für hochsensible Unternehmensdaten aus?
Ein vertraglicher Ausschluss des Modelltrainings auf Kundendaten (Zero Data Retention) verbessert zwar den Basisdatenschutz, beseitigt jedoch weder die Klartext-Verarbeitung im fremden Arbeitsspeicher noch den extraterritorialen Zugriffsvorbehalt nach dem US CLOUD Act. Für Geschäftsgeheimnisse, Berufsgeheimnisträger und kritische Infrastrukturen bleibt die lokale Ausführung innerhalb des eigenen Sicherheitsperimeters der einzig technisch belastbare Schutz.
Auditierbare Primärquellen & Technische Referenzen
| Institution & Herausgeber | Primärquelle & Normdokument | Architektonische Relevanz für den CIO |
|---|---|---|
| Europäische Union (Amtsblatt EUR-Lex) | Verordnung (EU) 2024/1689 (EU AI Act) ↗ | Verbindlicher Rechtsrahmen für KI-Systeme mit allgemeinem Verwendungszweck (GPAI), Transparenzpflichten und technischer Nachweisführung bei Hochrisiko-Anwendungen. |
| OWASP Foundation | OWASP Top 10 for LLM Applications ↗ | Referenzkatalog zur Abwehr von Prompt Injection, unkontrolliertem Datenabfluss (Sensitive Information Disclosure) und Manipulationen der Modell-Lieferkette. |
| Cloud Native Computing Foundation (CNCF) | CNCF Cloud Native AI & Kubernetes Standards ↗ | Architekturstandards für die containerisierte Orchestrierung von GPU-Workloads, vLLM-Inferenz-Clustern und herstellerneutralen API-Gateways. |
| Agentur der Europäischen Union für Cybersicherheit (ENISA) | ENISA Cybersecurity of AI & Threat Landscape ↗ | Europäische Prüfkriterien für die Härtung von Machine-Learning-Pipelines, Modell-Integritätsprüfungen und Resilienz unter der NIS-2-Richtlinie. |
| Bundesamt für Sicherheit in der Informationstechnik (BSI) | BSI IT-Grundschutz-Kompendium & KI-Leitfäden ↗ | Verbindliche Vorgaben für Mandantentrennung, kryptografische Absicherung von Modell-Artefakten und den Schutz vertraulicher Trainings- und Kontextdaten. |
*Modellrechnung: Alle angegebenen Lizenz-, Infrastruktur- und TCO-Werte verstehen sich als unverbindliche Beispielkalkulation auf Basis typischer Szenarien.
**Verweise auf Gesetzestexte, Paragrafen (u. a. DSGVO, NIS-2, EU AI Act, DORA, GoBD, BetrVG) und Compliance-Normen dienen ausschließlich der unverbindlichen technischen Fachinformation für IT-Entscheider. Sie stellen keine Rechtsberatung nach dem Rechtsdienstleistungsgesetz (RDG) dar; für eine rechtsverbindliche Beurteilung Ihrer spezifischen Unternehmensorganisation konsultieren Sie bitte Ihren Rechtsbeistand oder Datenschutzbeauftragten.

DAS CxO-PARADOX
Wie falsche digitale Souveränität Wirtschaft und Staat entkernt und wie echte Unabhängigkeit gelingt.
Von Mathias Diwo · Executive Tech Advisor
- ✓ 6-Hebel-Plan: Geordneter Ausstieg aus VMware- & Hyperscaler-Lock-ins
- ✓ Board Scorecard: One-Page IT-Governance für Vorstand & Aufsichtsrat
- ✓ Sofort lesbar: Vollständiges Kapitel 1 als Vorab-Dossier
Strategische Vertiefung im gleichen Themencluster
Weiterführende Architektur- und Handlungsleitfäden für CIOs & IT-Entscheider.

Sovereign AI & Lokale LLMs: Enterprise-RAG unter DSGVO und EU AI Act
Externe Cloud-KI-APIs gefährden Geschäftsgeheimnisse und führen bei produktiven Unternehmens-Workloads zu unkontrollierbaren Token-Kosten. Dieser Leitfaden zeigt die Referenzarchitektur für lokale Sprachmodelle mit vLLM, Qdrant und mandantensicherem RAG unter DSGVO und EU AI Act.

Lokale LLMs und Enterprise RAG: Datenschutzkonforme KI ohne Cloud-Zwang
Die Anbindung externer US-Cloud-Sprachmodelle gefährdet Geschäftsgeheimnisse und verletzt die DSGVO. Dieser Architektur-Leitfaden zeigt den Aufbau einer autarken Enterprise-RAG-Pipeline mit lokalen Open-Weight-Modellen, Qdrant, Keycloak-RBAC und vLLM.

Mathias Diwo
Herausgeber & Executive Tech AdvisorGründer von TechNavigator.de, Buchautor (HYBRID WORK) und strategischer Beirat für CIOs und Vorstände. Begleitet mittelständische Konzerne und Verwaltungsorganisationen bei Cloud-Exit-Strategien, NIS-2 Haftungsschutz und digitaler Souveränität.