
Ceph Storage vs. NetApp & Pure Storage: Software-Defined Storage (SDS)
Executive Summary
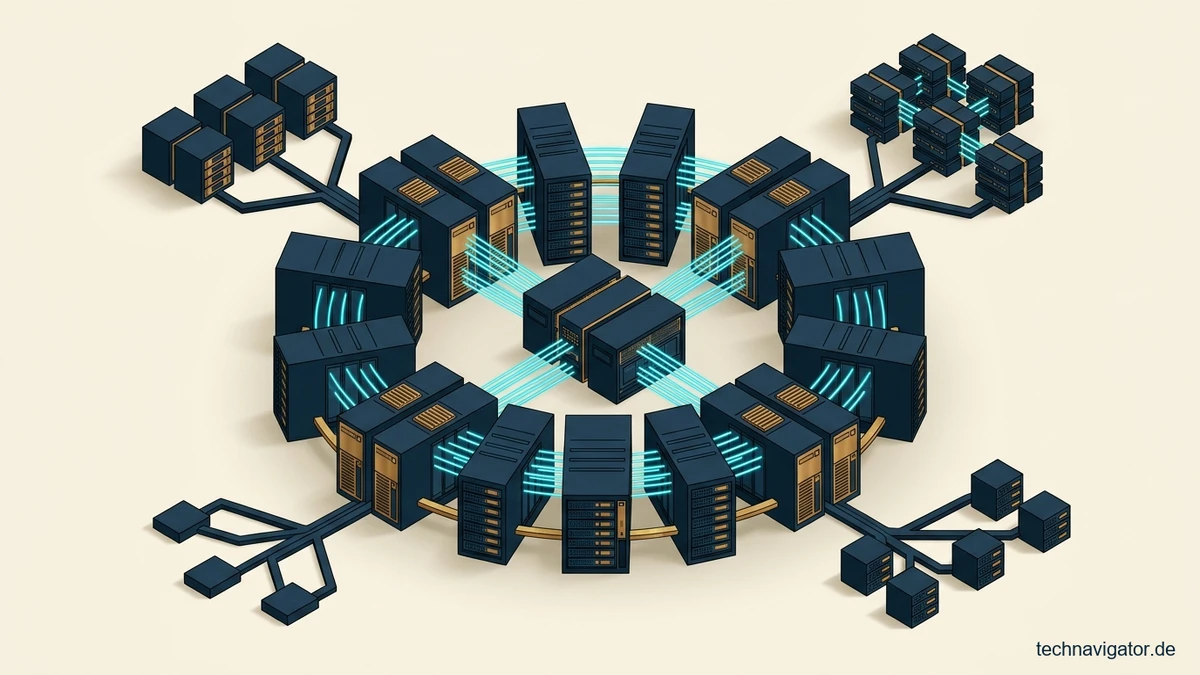
- ✓Unified Storage ohne Controller-Flaschenhals: Ceph vereint hochperformanten Blockspeicher (RBD für Proxmox, KVM und Kubernetes), POSIX-Dateisysteme (CephFS) und S3-Object-Storage (RGW) in einem einzigen, linear skalierenden Cluster.
- ✓Ende der 5-Jahres-Wartungsfalle bei Hardware-SANs: Während Hersteller wie NetApp, Pure Storage oder Dell EMC für jedes proprietäre NVMe-Laufwerk und jede Wartungsverlängerung nach dem 3. Jahr Aufschläge von bis zu 400 Prozent verlangen, nutzt Ceph offene Standard-Serverhardware.
- ✓Mathematische Datenintegrität durch CRUSH und BlueStore: Statt zentraler Lookup-Tabellen berechnet jeder Client den Speicherort seiner Datenblöcke direkt über den CRUSH-Algorithmus, während kontinuierliches Deep Scrubbing für kompromisslose Datenintegrität sorgt.
- ✓Selbstheilende Scale-Out-Architektur: Fällt eine Festplatte, ein kompletter Server oder ein ganzes Rack aus, stellt Ceph die definierte Replikationsstufe vollautomatisch im Hintergrund wieder her, ohne dass Datenbanken oder virtuelle Maschinen pausieren müssen.
Im traditionellen Rechenzentrumsbetrieb glich die Beschaffung von zentralem Enterprise-Storage über Jahrzehnte einem vorhersehbaren Ritual: Alle fünf Jahre wurde ein proprietäres Dual-Controller-Speichersystem (SAN oder NAS) von Herstellern wie NetApp, Pure Storage, Dell EMC oder HPE angeschafft. Sobald im dritten Betriebsjahr zusätzliche Kapazität benötigt wurde oder im vierten Jahr die Wartungsverlängerung (Support Renewal) anstand, sahen sich CIOs mit Preisforderungen konfrontiert, die oft einen kompletten Neukauf erzwangen.
Technisch kranken klassische Dual-Controller-SAN-Systeme zudem an einer strukturellen Grenze: Egal wie viele Laufwerks-Shelfs nachgerüstet werden, der gesamte Datenverkehr aller virtuellen Maschinen und Datenbankmanagementsysteme (DBMS) muss stets durch das Nadelöhr von genau zwei proprietären Storage-Controllern fließen.
Software-Defined Storage (SDS) mit Ceph bricht dieses Monopol auf. Als reines Open-Source-System verwandelt Ceph handelsübliche x86- oder ARM-Standardserver mit Enterprise-NVMe-Laufwerken in einen selbstheilenden, horizontal skalierenden Speicherpool, bei dem mit jedem zusätzlichen Server nicht nur der Speicherplatz, sondern auch die Rechen- und Netzwerkleistung linear mitwächst.
Die Architektur von Ceph: RADOS, CRUSH-Algorithmus und BlueStore
Um zu verstehen, warum Organisationen wie das CERN, große europäische Cloud-Provider und tausende Mittelständler ihre kritischen Produktivdatenbank- und Virtualisierungscluster auf Ceph betreiben, lohnt ein Blick in das architektonische Fundament (RADOS: Reliable Autonomic Distributed Object Store):
- Deterministische Platzierung per CRUSH-Algorithmus: In herkömmlichen Speichersystemen muss bei jedem Lese- oder Schreibzugriff ein zentraler Metadaten-Controller gefragt werden, wo ein Datenblock liegt. In Ceph berechnet der Client (z. B. der Proxmox-Hypervisor oder Kubernetes-Knoten) anhand der Cluster-Topologie (Failure Domains wie Server, Rack, Brandabschnitt) mathematisch selbst, welchen Object Storage Daemon (OSD) er direkt anspricht.
- BlueStore-Engine für direkten Hardware-Zugriff: Ceph umgeht langsame Linux-Zwischendateisysteme und beschreibt die rohen NVMe- und SSD-Blockgeräte direkt über seine eigene Transaktions-Engine BlueStore mit einer hochoptimierten RocksDB für Metadaten und Write-Ahead-Logs (WAL).
- Drei Speicherprotokolle auf einem einzigen Datenpool: Über dem gemeinsamen RADOS-Pool stellt Ceph gleichzeitig Blockspeicher (RBD für virtuelle Maschinen und relationale Datenbanken), ein verteiltes POSIX-Dateisystem (CephFS für gemeinsame Dateiablagen) und ein S3-/Swift-kompatibles Object Gateway (RGW) bereit.
- Garantierte Datenintegrität durch Scrubbing: Im Gegensatz zu einfachen Storage-Lösungen prüft Ceph durch tägliches Light Scrubbing und wöchentliches bitgenaues Deep Scrubbing sämtliche gespeicherten Replikate auf Prüfsummenfehler und überschreibt defekte Sektoren automatisch mit einer intakten Kopie.
Architektonischer Blindspot: Consumer-SSDs ohne Power-Loss-Protection (PLP) in Ceph
Der häufigste und teuerste Anfängerfehler beim Eigenbau eines Ceph-Clusters ist der Einkauf günstiger Desktop-/Consumer-NVMe-SSDs. Da Ceph für konsistente Datenbanktransaktionen extrem viele synchrone Schreibvorgänge (`fsync`) absetzt, brechen Consumer-SSDs ohne eigene Stützkondensatoren (Power Loss Protection, PLP) in der Schreib-Latenz von unter einer Millisekunde auf über fünfzig Millisekunden ein und verschleißen binnen weniger Monate. Enterprise-Datacenter-NVMe-Drives mit PLP sind ausnahmslos Pflicht.
Wie Sie die physische Rechenzentrumsumgebung für hochdichte Server- und Storage-Cluster energieeffizient auslegen, zeigt unser Leitfaden zu Rechenzentrumsbetrieb, PUE-Effizienz und Hochverfügbarkeit.
Ergänzende Architektur-Analysen und technische Entscheidungsmatrizen für Ihre IT-Planung finden Sie in unseren weiterführenden Leitartikeln zu Cloud-Exit-Strategie im Enterprise-Einsatz sowie zu VMware Broadcom Exit im Enterprise-Einsatz.
Ceph versus NetApp ONTAP und Pure Storage FlashArray: Wo liegt die Grenze?
Eine seriöse Architekturberatung verschweigt nicht, dass proprietäre All-Flash-Arrays von Pure Storage oder NetApp in bestimmten Nischen technisch glänzen. Wer lediglich zwei Dutzend Terabyte extrem latenzkritischer Oracle- oder SAP-HANA-Datenbanken betreibt und im eigenen Haus über keinerlei Linux-Kenntnisse verfügt, erhält mit einer schlüsselfertigen 3-HE-Appliance von Pure Storage oder NetApp ein extrem wartungsarmes System mit hervorragender Hardware-Komprimierung.
Sobald die Speicherlandschaft jedoch über 100 Terabyte hinauswächst, VMware vSphere durch Proxmox VE oder Kubernetes (Rook-Ceph) abgelöst wird oder eine echte Standort-Redundanz (Stretch Cluster über zwei Rechenzentren) gefragt ist, dreht sich das Verhältnis klar zugunsten von Ceph als Software-Defined Storage:
- Hyperkonvergenz (HCI) mit Proxmox: Für mittelgroße Umgebungen (3 bis 7 Knoten) lässt sich Ceph direkt in die Proxmox-VE-Weboberfläche integriert auf denselben Servern betreiben; für große Rechenzentren wird Ceph als dedizierter Storage-Cluster mit `cephadm` bereitgestellt.
- Freie Wahl der Server-Hersteller: Ein Ceph-Cluster akzeptiert Enterprise-NVMe-Laufwerke von Samsung, Kioxia, Micron oder Solidigm in beliebigen Dell-, Lenovo-, Supermicro- oder Thomas-Krenn-Servern ohne künstliche Firmware-Sperren.
- Migration im laufenden Betrieb: Nach fünf Jahren wird kein teurer Komplett-Migrationsmarathon fällig: Neue Serverknoten werden einfach in den Cluster aufgenommen, Ceph verschiebt die Daten im Hintergrund selbstständig, und die alten Server werden im laufenden Betrieb ausgeschaltet.
- Hohe IOPS für Datenbanken (DBMS): Mit dem neuen Crimson-OSD-Projekt (Seastar-Framework) und NVMe-over-Fabrics (NVMe/TCP) rückt Ceph auch bei extrem hohen IOPS-Zahlen für relationale Datenbankmanagementsysteme (DBMS) dicht an dedizierte Hardware-SANs heran.
„Proprietäre Storage-Hersteller verkaufen heute Standard-x86-Prozessoren und Standard-NVMe-Chips mit einem vierhundertprozentigen Software-Aufschlag. Mit Ceph bezahlen Sie die Hardware zum Marktpreis und behalten die Architekturhoheit im eigenen Haus.“
Wie Sie die auf Ceph gespeicherten virtuellen Maschinen und Datenbanken unveränderlich gegen Ransomware sichern, erläutert unser Vergleich Proxmox Backup Server vs. Veeam.
System-Matrix: NetApp / Pure Storage (Proprietäres SAN/NAS) versus Ceph SDS
Die folgende Übersicht bewertet klassische Enterprise-Storage-Appliances und einen All-Flash-NVMe-Ceph-Cluster im direkten Vergleich:
| Architektur-Dimension | NetApp ONTAP / Pure Storage FlashArray | Ceph Software-Defined Storage (All-NVMe) | C-Level-Bewertung |
|---|---|---|---|
| Erweiterungskosten ( $/TB ) | Hersteller-gebundene Laufwerke mit 300 bis 500 % Aufschlag | Standard Enterprise-NVMe-Drives zum freien Marktpreis |
–65 % Hardware-TCO*Kein Vendor-Lock-in
|
| Skalierungs-Architektur | Scale-Up (limitiert durch 2 zentrale Controller) | Echtes Scale-Out (von 3 bis über 1.000 Serverknoten) |
Lineares WachstumKein Controller-Limit
|
| Protokoll-Vielfalt | Oft getrennte Produktlinien oder Zusatzlizenzen für Block/File/S3 | Block (RBD), File (CephFS) & Object (S3) Lizenzfrei integriert |
Unified StorageFür VMs, K8s & KI
|
| Platzbedarf & Einzel-Latenz | Extrem kompakt (3 HE) & ultraniedrige Latenz durch NVRAM | Mindestens 3 bis 5 Server (3x Replikation) & 25/100-GbE nötig |
Ab 50 bis 100 TB optimalNetzwerk-Design kritisch
|
| Lebenszyklus-Migration | Aufwendiger Array-Tausch nach 5 Jahren (oder teures Evergreen-Abo) | Knotenweiser Hardware-Tausch im laufenden Betrieb ohne Downtime |
Ewiger DatenpoolNie wieder Datenmigration
|
Wirtschaftliche TCO-Analyse: 300 TB nutzbarer All-Flash-Enterprise-Storage über 60 Monate (5 Jahre)
Weil die Kostenfalle proprietärer SAN-Systeme besonders bei Kapazitätserweiterungen und im 4. und 5. Betriebsjahr zuschlägt, betrachtet die folgende Wirtschaftlichkeitsrechnung einen Zeitraum von 60 Monaten für 300 Terabyte nutzbare All-Flash-Kapazität (verteilt auf zwei Brandabschnitte):
| Kostenposition über 60 Monate (300 TB Netto All-Flash) | Proprietäres All-Flash-SAN (NetApp / Pure MetroCluster) | Ceph All-NVMe-Cluster (6x Server mit 3x Replikation, ~900 TB Raw) | Finanzieller Effekt (5 Jahre) |
|---|---|---|---|
| Initiale Hardware-Beschaffung inkl. Enterprise-NVMe & 100-GbE-Switches | 290.000 € | 135.000 € | + 155.000 € Einkaufsvorteil |
| Hersteller-Wartung, Software-Subskriptionen & Support (Jahr 1 bis 5) | 195.000 € | 35.000 € (Hardware-Garantie + optionales Consulting) | + 160.000 € Support-Ersparnis |
| Kapazitätserweiterung im 3. Jahr (+100 TB Netto nachkaufen) | 110.000 € | 32.000 € (2 zusätzliche Standard-Nodes einschieben) | + 78.000 € Skalierungsvorteil |
| Mehrbedarf Strom/Rack-HE (6 Server vs. 2 SAN-Shelfs) & Admin-Aufwand | 40.000 € | 88.000 € | – 48.000 € Betriebsaufwand |
| Gesamtkosten (TCO) über 60 Monate | 635.000 € | 290.000 € | + 345.000 € Netto-Ersparnis (–54 %) |
Besonders im Zusammenspiel mit einer Ablösung von VMware vSphere durch Proxmox VE oder OpenStack entsteht ein hochintegrierter Infrastruktur-Stack, der gänzlich ohne proprietäre Storage- und Hypervisor-Abos auskommt.
Der 4-Phasen-Bauplan für einen produktiven Enterprise-Ceph-Cluster
Ein stabiler Ceph-Cluster verzeiht keine Kompromisse bei der Hardware- und Netzwerkauswahl. Die erfolgreiche Einführung folgt vier verbindlichen Architektur-Regeln:
Phase 1 (Monat 1): Hardware-Qualifizierung (PLP-NVMe) und redundantes 25/100-GbE-Netzwerk
Beschaffung von mindestens 4 bis 5 identischen Serverknoten, ausschließlich bestückt mit Rechenzentrums-NVMe-SSDs inklusive Power Loss Protection (PLP). Aufbau eines getrennten, redundanten Frontend- und Backend-Cluster-Netzwerks mit mindestens 25 GbE oder 100 GbE Bandbreite und Jumbo Frames (MTU 9000).
Phase 2 (Monat 2): Deployment per cephadm/Proxmox und CRUSH-Map-Design
Installation des aktuellen Ceph-Releases (Squid/Reef) und Definition der Ausfalldomänen (Failure Domains auf Host-, Rack- oder Raumebene). Für produktive Datenbank- und VM-Pools wird zwingend eine 3-fache Replikation (`size=3, min_size=2`) konfiguriert.
Phase 3 (Monat 3): Last- und Chaos-Testing (fio, OSD-Pull-Test und Switch-Failover)
Bevor die erste Produktivmaschine migriert wird, durchläuft der Cluster harte Stresstests: Ziehen einzelner NVMe-Drives unter Volllast, hartes Abschalten eines gesamten Serverknotens sowie Ausfall eines Top-of-Rack-Switches zur Messung der Selbstheilungsdauer.
Phase 4 (Monat 4): Live-Storage-Migration und Anbindung von Kubernetes (Rook/CSI)
Schrittweises Verschieben der virtuellen Festplatten vom alten SAN auf den neuen Ceph-RBD-Pool im laufenden Betrieb sowie Bereitstellung dynamischer Persistent Volumes (RWO über RBD und RWX über CephFS) für die Kubernetes-Plattform.
Fünf Kontrollfragen für CIOs und Storage-Architekten
1. Wie viel verlangt Ihr aktueller SAN-Hersteller für die Wartungsverlängerung im 4. und 5. Jahr?
Haben Sie sich vor Unterzeichnung eines neuen Storage-Vertrags die verbindlichen Support-Preise für die Jahre vier bis sechs sowie die Nachkaufpreise einzelner NVMe-Laufwerke schriftlich garantieren lassen?
2. Besitzen alle für Software-Defined Storage geplanten SSDs eine echte Power Loss Protection?
Prüft Ihr Einkauf anhand des technischen Datenblatts, dass ausnahmslos Enterprise-Datacenter-Laufwerke mit physischen Stützkondensatoren (PLP) und hoher Schreibhaltbarkeit (DWPD) verbaut werden?
3. Ist Ihr Storage-Netzwerk für den Selbstheilungs-Traffic (Recovery) ausreichend dimensioniert?
Steht für die interne Datenreplikation der Ceph-OSDs ein eigenes, redundantes 25-GbE- oder 100-GbE-Netzwerk bereit, damit ein Laufwerksausfall nicht die Lesezugriffe der produktiven Datenbanken bremst?
4. Betreiben Sie kritische Pools konsequent mit 3-facher Replikation (`size=3, min_size=2`)?
Vermeiden Sie im Produktivbetrieb strikt eine riskante 2-fache Replikation (`size=2`), bei der ein einziger zusätzlicher Sektorenfehler während eines Server-Neustarts zu Datenverlust führen kann?
5. Nutzen Sie für Kubernetes noch manuell angelegte NFS-Freigaben statt Ceph-CSI?
Können Ihre Entwickler über das Ceph-CSI-Plugin vollautomatisch sowohl schnellen Blockspeicher als auch mehrfach gleichzeitig beschreibbare Dateisysteme (ReadWriteMany via CephFS) direkt aus ihren YAML-Manifesten anfordern?
Strategisches Fazit: Software-Defined Storage beendet die Abhängigkeit von Hardware-Monopolen
Die Ära, in der Zuverlässigkeit im Rechenzentrum nur durch geschlossene Spezial-Appliances einzelner US-Hersteller erkauft werden konnte, ist vorbei. Mit Enterprise-NVMe-Laufwerken und 100-Gigabit-Ethernet-Netzwerken hat Standard-Serverhardware die Leistungsgrenzen klassischer Dual-Controller-SANs längst durchbrochen.
Unternehmen, die beim Aufbau ihres Ceph-Clusters auf sauberes Hardware-Sizing (PLP-SSDs, schnelles Netzwerk, 3x Replikation) achten, gewinnen eine unbegrenzt skalierbare, selbstheilende Speicherplattform für das nächste Jahrzehnt und halbieren ihre laufenden Infrastrukturkosten.
Häufig gestellte Fragen (FAQ) zu Ceph Storage und Enterprise SDS
Wie viele Server benötigt man mindestens für einen produktiven Ceph-Cluster?
Das technische Minimum für einen Cluster mit 3-facher Replikation sind 3 Serverknoten. Für einen echten Enterprise-Produktivbetrieb empfehlen wir jedoch mindestens 4 bis 5 Knoten: Fällt bei einem 3-Knoten-Cluster ein Server aus, kann Ceph die 3. Kopie nirgendwo anders wiederherstellen; erst ab 4 Knoten heilt sich der Cluster nach einem Komplettausfall vollautomatisch selbst.
Unterstützt Ceph auch Komprimierung und Deduplizierung wie NetApp oder Pure Storage?
Ceph unterstützt auf Ebene der BlueStore-Engine eine transparente Inline-Komprimierung (z. B. mit LZ4, Snappy oder Zstd), die sich pro Pool aktivieren lässt. Eine globale Inline-Deduplizierung über den gesamten verteilten Cluster wird aus Latenzgründen bewusst nicht für primären VM-Blockspeicher eingesetzt; da Standard-NVMe-Laufwerke auf dem freien Markt jedoch rund 70 Prozent günstiger sind als proprietäre SAN-Laufwerke, ist der Brutto-Speicherplatz bei Ceph trotz 3-facher Replikation meist deutlich preiswerter.
Kann man Ceph über zwei getrennte Rechenzentren oder Brandabschnitte spannen (Stretch Cluster)?
Ja. Sofern die beiden Standorte über eine redundante Glasfaserverbindung mit sehr geringer Latenz (unter 1 bis 2 Millisekunden Round-Trip-Time) verbunden sind, lässt sich Ceph im Stretch-Modus betreiben (je 2 Kopien pro Standort plus ein leichter Tiebreaker-Monitor an einem dritten Ort). Für weiter entfernte Standorte bietet Ceph eine asynchrone RBD- und S3-Spiegelung.
Was ist Rook-Ceph im Zusammenhang mit Kubernetes?
Rook ist ein von der Cloud Native Computing Foundation (CNCF) verabschiedeter Kubernetes-Operator, der Ceph direkt innerhalb eines Kubernetes-Clusters automatisiert bereitstellt, überwacht und skaliert. Dadurch erhalten Container-Workloads ohne externes SAN hochverfügbaren Block-, Datei- und Objektspeicher.
Gibt es kommerziellen Enterprise-Support für Ceph?
Ja. Unternehmen, die 24/7-Hersteller-SLAs benötigen, erhalten kommerziellen Enterprise-Support unter anderem über Proxmox Server Solutions (für hyperkonvergentes Proxmox-Ceph), IBM/Red Hat (Storage Ceph), Canonical (Ubuntu Ceph) oder spezialisierte europäische Ceph-Systemhäuser wie Croit.
Auditierbare Primärquellen & Technische Referenzen
| Institution & Herausgeber | Primärquelle & Normdokument | Architektonische Relevanz für den CIO |
|---|---|---|
| Bundesamt für Sicherheit in der Informationstechnik (BSI) | BSI IT-Grundschutz Baustein SYS.1.8 (Speicherlösungen & Storage-Netze) ↗ | Vorgaben zur Netzsegmentierung von Speichernetzen, Redundanzauslegung über Brandabschnitte und Integritätsprüfung gespeicherter Daten. |
| National Institute of Standards and Technology (NIST) | NIST SP 800-209 (Security Guidelines for Storage Infrastructure) ↗ | Sicherheitsarchitektur für Software-Defined Storage (SDS), Verschlüsselung ruhender Daten (Data-at-Rest) und Schutz der Storage-Control-Plane. |
| Deutsches Institut für Normung (DIN) | ISO/IEC 27040 (Informationstechnik und Speichersicherheit) ↗ | Internationaler Standard für Planung, Entwurf, Implementierung und sichere Löschung (Sanitization) von Enterprise-Speichersystemen. |
| Linux Foundation / Ceph Foundation | Ceph Foundation Architecture Specification (RADOS, CRUSH & BlueStore) ↗ | Primärdokumentation des deterministischen CRUSH-Verteilungsalgorithmus, der Paxos-Monitore und der BlueStore-Transaktionsarchitektur. |
*Modellrechnung: Alle angegebenen Lizenz-, Infrastruktur- und TCO-Werte verstehen sich als unverbindliche Beispielkalkulation auf Basis typischer Szenarien.

DAS CxO-PARADOX
Wie falsche digitale Souveränität Wirtschaft und Staat entkernt und wie echte Unabhängigkeit gelingt.
Von Mathias Diwo · Executive Tech Advisor
- ✓ 6-Hebel-Plan: Geordneter Ausstieg aus VMware- & Hyperscaler-Lock-ins
- ✓ Board Scorecard: One-Page IT-Governance für Vorstand & Aufsichtsrat
- ✓ Sofort lesbar: Vollständiges Kapitel 1 als Vorab-Dossier
Strategische Vertiefung im gleichen Themencluster
Weiterführende Architektur- und Handlungsleitfäden für CIOs & IT-Entscheider.
BATNA-Verhandlungsmacht im Microsoft-EA-Renewal: Open-Source-Parallel-Stack
Bei der Verlängerung dreijähriger Microsoft Enterprise Agreements drohen Aufschläge von 25 bis 35 Prozent durch E5-Upselling und KI-Kopplungen. Dieser Leitfaden zeigt, wie CIOs und Einkaufsleiter mit einem produktiven Open-Source-Parallel-Stack echte Verhandlungsmacht aufbauen.
MinIO vs. AWS S3: On-Premises Object Storage und S3-Datenhoheit
Architekturvergleich zwischen MinIO und Amazon S3: Wie CIOs unstrukturierte Daten, KI-Data-Lakes und Backups ohne Egress-Gebühren im eigenen Rechenzentrum speichern.

Mathias Diwo
Herausgeber & Executive Tech AdvisorGründer von TechNavigator.de, Buchautor (HYBRID WORK) und strategischer Beirat für CIOs und Vorstände. Begleitet mittelständische Konzerne und Verwaltungsorganisationen bei Cloud-Exit-Strategien, NIS-2 Haftungsschutz und digitaler Souveränität.