
Verteilte Cloud-Computing-Dienste: Edge-Clouds und föderierte Control Planes
Executive Summary
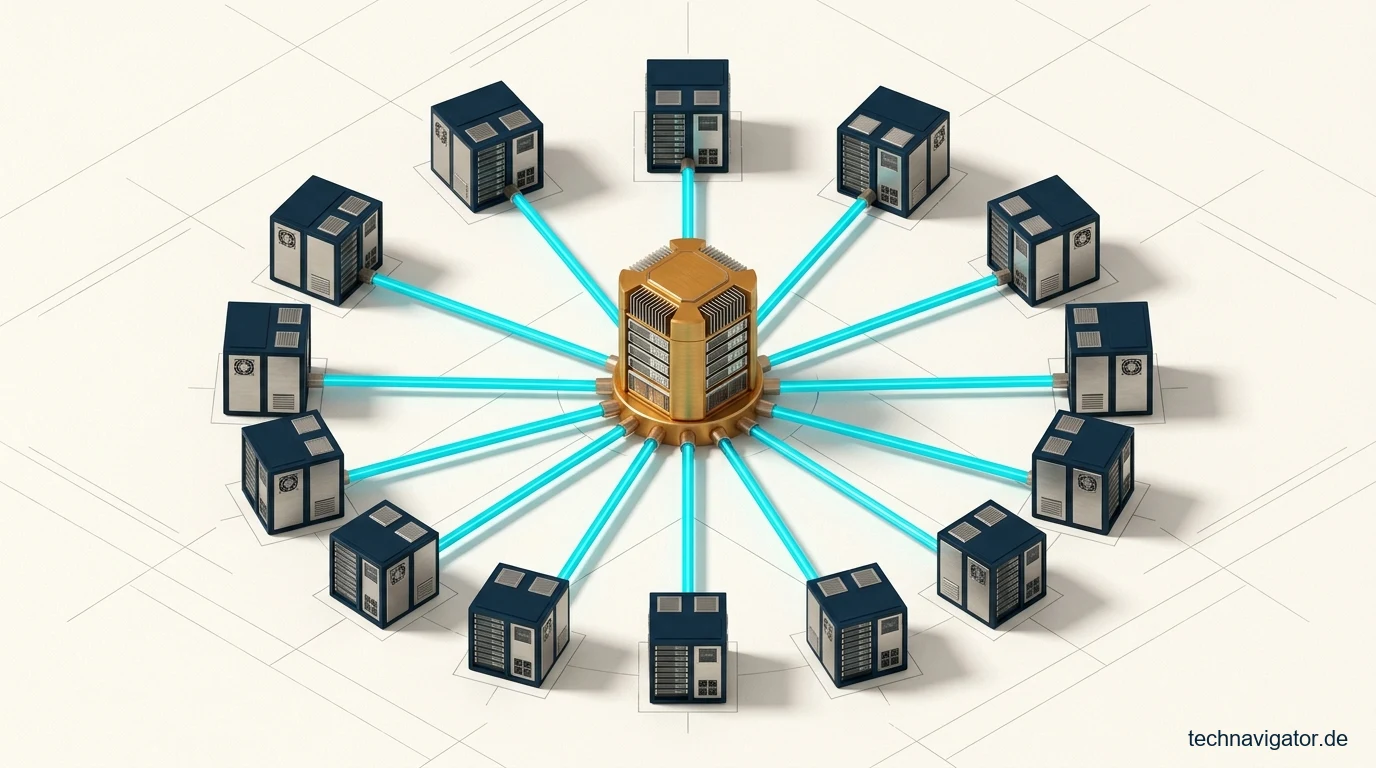
- ✓Entkopplung von Ort und Steuerung: Nach dem Distributed-Cloud-Paradigma von Gartner und NIST trennen moderne Architekturen den physischen Standort der Datenverarbeitung strikt von der übergeordneten administrativen Control Plane.
- ✓Schutz vor proprietären Edge-Appliances: Herstellerspezifische Systeme wie AWS Outposts, Azure Local oder Google Distributed Cloud verlagern den US-Hyperscaler-Lock-in direkt in das eigene Werk oder Klinikum.
- ✓Souveräne Multi-Cluster-Orchestrierung: Mit Kubernetes Cluster API, CNCF Karmada, SUSE Rancher und eBPF-basiertem Cilium Cluster Mesh steuern Unternehmen hunderte Standorte herstellerneutral und offline-autark.
- ✓Über 68 Prozent TCO*-Vorteil über 60 Monate: Lokale Vorfilterung auf Standard-COTS-Hardware beseitigt Egress-Gebühren und sichert die volle Konformität mit DORA** Artikel 28 sowie DSGVO Artikel 28.
Über mehr als ein Jahrzehnt folgte die Cloud-Strategie vieler Großunternehmen einem einfachen Zentralisierungsmuster: Datenbestände, Applikationsserver und Analyse-Pipelines wurden in wenigen gigantischen Rechenzentren globaler Public-Cloud-Anbieter zusammengezogen. Für das moderne Industrieunternehmen, vernetzte Klinikverbünde, Finanzinstitute und Betreiber kritischer Versorgungsinfrastrukturen stößt diese Konzentration heute an harte physikalische, ökonomische und regulatorische Grenzen.
Sobald Fertigungslinien optische Qualitätskontrollen im Millisekundenbereich durchführen, medizinische Hochleistungsdiagnostik Terabytes an Rohdaten erzeugt oder Bankfilialen strenge lokale Aufbewahrungspflichten erfüllen müssen, wird der permanente Datentransport in ein entferntes Zentralrechenzentrum zum operativen Risiko. Die Lichtgeschwindigkeit in Glasfasernetzen setzt der Netzwerklatenz unüberwindbare Schranken, während ausufernde Egress-Gebühren für den Rücktransport verarbeiteter Daten die Wirtschaftlichkeitsrechnung belasten.
Verteilte Cloud-Computing-Dienste (Distributed Cloud) lösen diesen Zielkonflikt durch einen tiefgreifenden Architekturwechsel auf. Gemäß den Referenzmodellen von Gartner und dem National Institute of Standards and Technology (NIST) wird die physische Ausführung von Cloud-Diensten geografisch dorthin verlagert, wo Daten entstehen, während Bereitstellung, Sicherheitsrichtlinien und Updates über eine föderierte Steuerungsebene synchronisiert bleiben. Dieser Leitfaden zeigt, wie CIOs verteilte Cloud-Topologien ohne neue Herstellerabhängigkeiten aufbauen.
Das Distributed-Cloud-Paradigma: Entkopplung von physischer Lokation und Control Plane
In der klassischen Systemarchitektur waren der Aufstellungsort eines Servers und seine administrative Verwaltung untrennbar miteinander verschmolzen. Entweder stand die Hardware als isoliertes Silo im lokalen Serverraum einer Niederlassung und musste vor Ort manuell gepflegt werden, oder der Workload lief vollständig in einer entfernten Public-Cloud-Region unter den Bedingungen des jeweiligen Providers.
Das Konzept der Distributed Cloud durchbricht diese Dichotomie, indem es die Daten- und Ausführungsebene (Data Plane) konsequent von der Steuerungsebene (Control Plane) trennt. Rechenknoten, Container-Laufzeitumgebungen und persistente Speicherpools befinden sich physisch direkt im Produktionswerk, im Krankenhaus, in der Bankfiliale oder in regionalen Metro-Colocation-Zentren. Gleichzeitig werden sämtliche Cluster über deklarative Schnittstellen und GitOps-Mechanismen wie eine einzige logische Plattform verwaltet.
Für die Einordnung in die übergeordnete Unternehmensarchitektur empfiehlt sich ein Abgleich mit den etablierten Cloud-Deployment-Modellen im Enterprise-Vergleich. Während klassische Hybrid-Clouds meist zwei getrennte Welten mühsam über proprietäre Gateways verknüpfen, schafft eine sauber entworfene Distributed Cloud ein einheitliches Betriebsmodell über alle Lokationen hinweg.
Data Gravity, deterministische Latenz und lokale Datenresidenz
Drei technische Treiber erzwingen heute diese Dezentralisierung der Ausführungsebene. Der erste Faktor ist die sogenannte Data Gravity: Moderne Sensoren, hochauflösende Industriekameras und bildgebende Verfahren in der Medizin erzeugen Datenmengen, deren Gewicht eine kontinuierliche Übertragung über Weitverkehrsnetze (WAN) technisch und kaufmännisch ausschließt. Die Rechenlogik muss zwingend zu den Daten wandern.
Der zweite Treiber ist das Erfordernis deterministischer Echtzeit-Latenzen. Wenn autonome Flurförderzeuge in einem Logistikzentrum kollisionsfrei navigieren oder Schutzrelais in einem Umspannwerk Netzfrequenzen ausbalancieren, müssen Steuerbefehle innerhalb von ein bis fünf Millisekunden verarbeitet werden. Warum diese physikalische Nähe für vernetzte Geräte unverzichtbar ist, beleuchtet unsere Analyse, warum Sie Edge Computing für das industrielle IoT benötigen.
Der dritte Faktor betrifft die durchsetzbare Datenresidenz am Entstehungsort. In regulierten Sektoren dürfen personenbezogene Patientendaten, Kontobewegungen oder geschützte Konstruktionsparameter das Gelände des Krankenhauses, der Landesbank oder der Fertigungsstätte im Rohformat überhaupt nicht verlassen. Eine verteilte Cloud-Architektur stellt sicher, dass Rohdaten lokal ausgewertet und anonymisiert werden, bevor aggregierte Metriken das Haus verlassen.
Architektonischer Blindspot: Die Schein-Autonomie proprietärer Hyperscaler-Edge-Appliances
Viele IT-Entscheider beschaffen proprietäre Edge-Racks wie AWS Outposts, Azure Local oder Google Distributed Cloud in dem Glauben, damit lokale Ausfallsicherheit zu erwerben. Doch diese Systeme sind als unselbstständige Satelliten der US-Muttercloud konstruiert: Bricht die WAN-Verbindung längerfristig ab, laufen kryptografische Sitzungs-Tokens aus, lokale Verwaltungs-APIs sperren Schreibzugriffe und ein Neustart von Workloads scheitert an der fehlenden Verbindung zur zentralen Hyperscaler-Control-Plane.
Wer seine Standorte gegen Ausfälle von Weitverkehrsverbindungen oder Störungen übergeordneter Cloud-Regionen absichern will, darf keine Architektur wählen, deren Gehirn tausende Kilometer entfernt in einem fremden Rechenzentrum schlägt. Wahre Resilienz erfordert eine verteilte Topologie, bei der jeder Standort im Ernstfall wochenlang als autarke Insel weiterarbeiten kann.
Ergänzende Architektur-Analysen und technische Entscheidungsmatrizen für Ihre IT-Planung finden Sie in unseren weiterführenden Leitartikeln zu Cloud-Exit-Strategie im Enterprise-Einsatz, zu Cloud-Kommunikation im Enterprise-Einsatz sowie zu Google Anthos im Enterprise-Einsatz.
Hyperscaler-Appliances versus offene Multi-Cluster-Orchestrierung
Auf dem Markt für verteilte Cloud-Dienste stehen sich heute zwei unvereinbare Architekturphilosophien gegenüber. Auf der einen Seite bieten die großen US-Hyperscaler schlüsselfertige Hardware- und Software-Appliances an, die ihre proprietären Cloud-APIs bis in das Kundenrechenzentrum verlängern. Dazu zählen insbesondere AWS Outposts, Microsoft Azure Local (vormals Azure Stack HCI) sowie Google Distributed Cloud (GDC / Anthos).
Der vermeintliche Charme dieser Angebote liegt darin, dass Entwicklerteams ihre gewohnten proprietären Dienste wie AWS ECS, RDS oder Azure Resource Manager unverändert vor Ort nutzen können. In der kaufmännischen und betrieblichen Praxis erweist sich diese Bequemlichkeit jedoch schnell als gravierende Einschränkung. Unternehmen mieten überteuerte Blackbox-Hardware, deren Firmware-, Hypervisor- und Telemetrieschichten vollständig durch den US-Anbieter kontrolliert werden.
Zudem entsteht eine doppelte Kostenbelastung: Neben den hohen monatlichen Bereitstellungsgebühren für die physischen Racks oder Host-Lizenzen fallen für jede lokal ausgeführte Instanz und jeden verwalteten Container fortlaufende Cloud-Nutzungsgebühren an. Ein Wechsel zu einem anderen Infrastrukturbetreiber ist ohne komplettes Neuschreiben der Bereitstellungs-Skripte und Applikations-Integrationen kaum möglich.
Souveräne Steuerung mit Cluster API, Karmada, Rancher und Cilium
Den Gegenentwurf bildet ein offener, föderierter Cloud-Stack auf Basis von Standards der Cloud Native Computing Foundation (CNCF). Statt proprietärer Racks nutzen Unternehmen zertifizierte Standard-Industrieserver (Commercial Off-The-Shelf, COTS) von Herstellern wie Dell, HPE, Lenovo oder spezialisierten Industrie-PC-Ausrüstern, bestückt mit einem gehärteten Linux-Unterbau und leichtgewichtigen Kubernetes-Distributionen wie K3s oder RKE2.
Jeder dezentrale Standort an der Klinikkante, in der Werkhalle oder in der Regionalfiliale erhält dabei seine eigene, vollwertige lokale Control Plane (bestehend aus lokalem API-Server, Scheduler und eingebettetem etcd- oder SQLite-Zustandsspeicher). Fällt die Außenverbindung aus, trifft das lokale Cluster sämtliche Entscheidungen zu Self-Healing, Pod-Neustarts und lokaler Speicherzuweisung vollkommen autonom.
„Eine verteilte Cloud verdient ihren Namen nur dann, wenn jeder Edge-Standort den Abriss der zentralen Datenleitung überlebt: Föderierte Open-Source-Control-Planes garantieren lokale Überlebensfähigkeit, während proprietäre Hyperscaler-Appliances bei Verbindungsverlust zur teuren Altmetall-Kulisse erstarren.“
Über diesen autonomen Standort-Clustern spannt sich die föderierte Verwaltungsebene auf. Mit der Kubernetes Cluster API (CAPI) wird der gesamte Lebenszyklus hunderter dezentraler Cluster deklarativ wie regulärer Programmcode verwaltet. Werkzeuge wie SUSE Rancher oder das CNCF-Projekt Karmada (Kubernetes Armada) ermöglichen es, Applikationen über standortübergreifende Propagation-Policies gleichzeitig auf dutzende Lokationen auszurollen.
Für die sichere Vernetzung zwischen den verteilten Standorten sorgt Cilium Cluster Mesh auf Basis von eBPF direkt im Linux-Kernel. In Verbindung mit standardisierten VXLAN-Overlays (RFC 7348) oder modernen WireGuard-Tunneln sowie SPIFFE/SPIRE für kryptografische Workload-Identitäten entsteht ein hochperformantes Zero-Trust-Netzwerk. Wie das darunterliegende Weitverkehrsnetz optimal ausgelegt wird, zeigt unser Beitrag zum Enterprise-Backbone als Rückgrat verteilter Infrastrukturen.
Einheitliche GitOps-Policies bei strikter lokaler Datenhoheit
Ein entscheidender Architekturvorteil des offenen Föderationsmodells liegt im Pull-Prinzip moderner GitOps-Engines wie ArgoCD oder Flux. Statt dass ein zentraler Management-Server von außen privilegierten Schreibzugriff (Push) in das Sicherheitsnetz einer Fabrik oder eines Krankenhauses benötigt, läuft in jedem Edge-Cluster ein lokaler GitOps-Agent.
Dieser Agent fragt in definierten Intervallen über eine ausgehende, mTLS-verschlüsselte Verbindung das zentrale Git-Repository des Unternehmens ab, zieht freigegebene Konfigurationsänderungen und wendet sie lokal an. Selbst wenn die Verbindung zum zentralen Repository tagelang unterbrochen ist, behält der lokale Agent den letzten validierten Soll-Zustand (Desired State) bei und korrigiert Konfigurationsabweichungen vor Ort selbstständig.
Ergänzt durch Policy-Engines wie Kyverno oder Open Policy Agent (OPA Gatekeeper) lässt sich kryptografisch erzwingen, dass an bestimmten Standorten ausschließlich digital signierte Container-Images aus der lokalen Standort-Registry (Harbor) starten dürfen. Für stark regulierte Wirtschaftszweige ersetzt dieser Aufbau teure Speziallösungen, wie unser Überblick zu regulierungskonformen Branchen-Clouds im Enterprise-Einsatz vertieft.
Architektur- und Betriebsvergleich: Hyperscaler-Edge versus Sovereign Multi-Cluster
Für eine fundierte Architekturentscheidung im IT-Lenkungsausschuss müssen technische Überlebensfähigkeit, Netzwerksouveränität und Lizenzmechanik systematisch gegenübergestellt werden. Oft zeigt sich erst bei der Analyse von Störfallszenarien, wie stark proprietäre Edge-Erweiterungen die operative Handlungsfähigkeit einschränken.
Die nachfolgende Bloomberg-Radar-Matrix vergleicht proprietäre Hyperscaler-Edge-Appliances mit einer offenen, föderierten Kubernetes-Architektur anhand der fünf wichtigsten Entscheidungsdimensionen für den CIO:
| Architektur- & Betriebskriterium | Hyperscaler Distributed Cloud (Outposts / Azure Local / GDC) | Souveräne Multi-Cluster-Föderation (CAPI / Karmada / Cilium) | CIO-Bewertung |
|---|---|---|---|
| 1. Control-Plane-Autonomie & Offline-Betrieb | Steuerungsebene liegt in der zentralen Public Cloud; bei längerem WAN-Ausfall drohen Token-Ablauf und Verlust lokaler Mutationen. | Vollwertige lokale Control Plane (K3s/RKE2) pro Standort; unbegrenzter Inselbetrieb inklusive Self-Healing bei gekappter Außenleitung. |
100 % InselbetriebZeitlich unbegrenzt autark
|
| 2. Hardware-Wahlfreiheit & Lebenszyklus | Zwang zu proprietären Miet-Racks oder streng limitierten OEM-Appliances; erzwungener Hardware-Tausch nach Herstellervorgabe. | Freie Wahl beliebiger x86-, ARM- und GPU-Industrieserver (COTS) mit standardisiertem Redfish/IPMI-Management. |
Freie COTS-WahlKein Hardware-Lock-in
|
| 3. Multi-Cluster-Netzwerk & Service-Mesh | Proprietäre Cloud-VPN-Gateways und herstellerspezifische Routing-Tabellen; hohe Zusatzkosten für standortübergreifenden Traffic. | Offenes Cilium Cluster Mesh mit Kernel-eBPF, RFC-7348-VXLAN und WireGuard-Verschlüsselung direkt zwischen den Standorten. |
Zero-Trust-MeshDirektes eBPF-Routing
|
| 4. Datenresidenz & Telemetrie-Hoheit | Permanenter Abfluss von System- und Abrechnungs-Telemetrie in US-Steuerungsregionen; dem US CLOUD Act unterworfen. | Sämtliche Roh-, Log- und Metrikdaten verbleiben im Standort-Cluster (VictoriaMetrics / Lokal-Ceph); null externer Telemetriezwang. |
DSGVO- & DORA-festVolle lokale Datenhoheit
|
| 5. Kostenstruktur & Egress-Gebühren | Hohe monatliche Appliance-Grundmiete plus vCPU-Aufschläge und signifikante Egress-Tarife bei Datenabzug aus der Cloud. | Planbare Hardware-Abschreibung (CAPEX) und lineare Open-Source-Support-Subskriptionen ohne jegliche Datentransfergebühren. |
Über 68 % TCO-VorteilNull Egress-Gebühren
|
Die Gegenüberstellung macht deutlich, warum führende Industrie- und Finanzunternehmen bei der Modernisierung ihrer Außenstandorte zunehmend auf offene Multi-Cluster-Föderationen setzen. Statt für jeden einzelnen Edge-Standort einen proprietären Mietvertrag abzuschließen, schafft der CNCF-Stack eine universelle Infrastruktur-Abstraktion.
Selbst wenn ein Teil der zentralen Analyse-Workloads weiterhin in einer europäischen Public Cloud oder einem Colocation-Rechenzentrum läuft, sind die dezentralen Standorte durch offene OCI-Container-Standards und deklarative Kubernetes-Manifeste vollständig portabel. Kein Standort ist technologisch an die Preispolitik eines einzelnen Cloud-Konzerns gekettet.
Vollkostenrechnung über 60 Monate: Warum proprietäre Edge-Racks die Bilanz belasten
Um die kaufmännische Tragweite für den Finanzvorstand (CFO) präzise zu beziffern, betrachten wir ein repräsentatives Enterprise-Szenario über einen Betrachtungszeitraum von 60 Monaten (fünf Jahre). Ein produzierendes Unternehmen oder ein Klinikverbund betreibt 20 dezentrale Standorte, an denen jeweils hochverfügbare Rechenkapazitäten im Umfang von 64 physischen CPU-Kernen, 512 Gigabyte RAM und 20 Terabyte schnellem NVMe-Speicher sowie monatlich 35 Terabyte lokales Rohdatenaufkommen verarbeitet werden müssen.
Beim Einsatz proprietärer Hyperscaler-Edge-Appliances (wie AWS Outposts oder Azure Local inklusive Cloud-Management-Aufschlag und Daten-Synchronisation) fallen pro Standort monatliche Appliance-, Host-Lizenz- und Supportgebühren von durchschnittlich 4.800 Euro an. Hinzu kommen rund 1.450 Euro pro Monat und Standort für Cloud-Control-Plane-Dienste, Snapshot-Backups in der Muttercloud sowie Egress- und Transfergebühren. Über alle 20 Standorte summiert sich dies auf 125.000 Euro monatlich beziehungsweise exakt 7,50 Millionen Euro über 60 Monate.
Demgegenüber steht der Aufbau einer souveränen Distributed-Cloud-Architektur mit jeweils drei kompakten, hochverfügbaren COTS-Serverknoten pro Standort (insgesamt 60 Server inklusive Enterprise-NVMe-Drives und 25-GbE-Switching). Die einmalige Hardware-Investition (CAPEX) beträgt 28.000 Euro pro Standort, also insgesamt 560.000 Euro für die gesamte Flotte. Da 95 Prozent der Rohdaten lokal durch eBPF und lokale Zeitreihendatenbanken vorgefiltert werden, entfallen Cloud-Egress-Gebühren vollständig.
Für den kommerziellen Enterprise-Support des Linux- und Kubernetes-Stacks (etwa SUSE Rancher Prime), das zentrale GitOps-Management sowie anteilige Betriebskosten fallen jährlich 310.000 Euro an (1,55 Millionen Euro über fünf Jahre). Zuzüglich 240.000 Euro für das Rollout-Projekt liegen die Fünfjahresgesamtkosten bei 2,35 Millionen Euro. Das Unternehmen spart netto 5,15 Millionen Euro (68,7 Prozent TCO-Reduktion) bei einem Break-Even im elften Monat.
Die Make-or-Buy Sourcing-Weiche und Compliance unter DORA Art. 28 und DSGVO Art. 28
Für die erfolgreiche Umsetzung einer verteilten Cloud-Architektur ist ein Betriebsmodell entscheidend, das zur personellen Ausstattung der eigenen Plattform-Organisation passt. In der Unternehmenspraxis haben sich drei klar abgegrenzte Sourcing-Varianten etabliert, die alle auf demselben offenen Technologiestandard aufbauen.
Erstens (Eigenbetrieb): Organisationen mit einem eigenen Platform-Engineering-Team ab vier bis sechs Spezialisten betreiben die zentrale Management-Ebene (Rancher, Karmada, ArgoCD) sowie die dezentralen K3s- oder RKE2-Cluster vollständig in Eigenregie. Die Hardware wird über Rahmenverträge direkt bei etablierten Serverherstellern beschafft, während kommerzielle Hersteller-Subscriptions die langfristige Versorgung mit Sicherheits-Patches und L3-Entwicklersupport absichern.
Zweitens (Co-Managed): Gehobene Mittelständler mit zehn bis dreißig Außenstandorten behalten die Hoheit über ihre Applikations-Deployments und Git-Repositories im Haus, übergeben jedoch das Lifecycle-Management des unterliegenden Betriebssystems (wie SUSE Linux Micro oder Talos Linux) und der Kubernetes-Schicht an einen europäischen Systemintegrator. Über klar definierte Übergabepunkte im Git-Workflow bleibt die Architektur jederzeit transparent und revisionssicher.
Drittens (Managed Service): Unternehmen ohne eigene Kubernetes-Betriebsmannschaft beziehen die verteilte Infrastruktur als schlüsselfertigen Managed Edge Service von einem nach BSI C5 und ISO 27001 testierten europäischen Provider. Vertraglich wird dabei zwingend vereinbart, dass sämtliche Konfigurations-Repositories (OpenTofu, Helm-Charts, Kustomize-Overlays) im Eigentum des Auftraggebers liegen, sodass ein Dienstleisterwechsel ohne Austausch der Standort-Hardware möglich bleibt.
Rechtlich löst diese offene Föderationsarchitektur zwei drängende Compliance-Probleme auf Vorstandsebene. Nach Artikel 28 der EU-Verordnung DORA (Verordnung (EU) 2022/2554) sowie den neuen Anforderungen des EU Data Act (Verordnung (EU) 2023/2854) müssen Unternehmen kritische Konzentrationsrisiken bei IKT-Drittdienstleistern vermeiden und die technische Wechselbarkeit innerhalb kurzer Fristen nachweisen. Eine auf offenen CNCF-Standards basierende Edge-Flotte erfüllt diese Portabilitätspflicht per Design.
Gleichzeitig schützt die strikte Entkopplung vor den Haftungsrisiken aus Artikel 28 DSGVO (Auftragsverarbeitung) und Kapitel V DSGVO (Drittlandtransfer). Wenn hochsensible Gesundheitsdaten im Krankenhaus, biometrische Zutrittsdaten im Werk oder Zahlungsverkehrsdaten in der Filiale auf lokalen Speichern unter eigener kryptografischer Schlüsselkontrolle verbleiben, findet kein Datenabfluss an außereuropäische Muttergesellschaften statt.
Der 4-Phasen-Umsetzungsfahrplan: Vom zentralen Engpass zur föderierten Edge-Flotte
Die Einführung einer verteilten Cloud-Topologie erfordert ein standardisiertes Vorgehen, das manuelle Eingriffe vor Ort durch vollautomatisierte Zero-Touch-Provisionierung ersetzt. Ein bewährter Rollout gliedert sich in vier aufeinander aufbauende Projektphasen über sechs bis neun Monate.
Phase 1 (Monat 1 bis 2): Datengravitations-Audit und Latenz-Klassifizierung
Zu Beginn analysiert das Architekturteam sämtliche Applikationen und Datenströme der Außenstandorte. Workloads werden danach klassifiziert, welche Prozesse zwingend unter fünf Millisekunden Latenz benötigen, welche Daten aus Datenschutzgründen lokal verbleiben müssen und welche Mindestanforderungen an die lokale Überlebensdauer bei einem kompletten Ausfall der WAN-Leitung bestehen.
Phase 2 (Monat 3 bis 4): Golden-Image-Blueprint und Zero-Touch-Provisionierung
Im zweiten Schritt entsteht der standardisierte Infrastruktur-Blueprint auf Basis eines unveränderbaren Betriebssystems wie SUSE Linux Micro oder Talos Linux mit K3s, Cilium Cluster Mesh und lokalem Ceph-Storage. Über sichere Boot-Mechanismen (iPXE / FIDO Device Onboard) konfigurieren sich neue Server nach dem Anschluss an Strom und Netzwerk vollautomatisch über das zentrale GitOps-Repository.
Phase 3 (Monat 5 bis 6): Pilot-Rollout an zwei Standorten und Disconnect-Härtetest
An zwei repräsentativen Betriebsstandorten (etwa einem Produktionswerk und einem Logistik- oder Klinikstandort) wird das erste Drei-Knoten-Edge-Cluster produktiv geschaltet. Vor der endgültigen Abnahme führt das Team einen realen Leitungstrenntest durch: Die externe Glasfaserverbindung wird physisch getrennt, um unter Echtbedingungen zu verifizieren, dass lokale Authentifizierung, Container-Failover, Datenpufferung und spätere Re-Synchronisation fehlerfrei greifen.
Phase 4 (Monat 7 bis 12): Flottenweiter Rollout und Rückbau überdimensionierter Cloud-Zentralen
Nach erfolgreichem Pilotbetrieb werden die weiteren Standorte in standardisierten Wellen über die zentrale Cluster-API- und Karmada-Steuerungsebene ausgerollt. Parallel dazu werden nicht mehr benötigte zentrale Cloud-Instanzen, proprietäre VPN-Gateways und teure Rohdaten-Speicherpools in der Public Cloud schrittweise abgebaut und die Einsparungen im FinOps-Dashboard dokumentiert.
Fünf Kontrollfragen für Vorstand und IT-Leitung zu verteilten Cloud-Architekturen
1. Wie lange überlebt unser kritischster Außenstandort, wenn heute die externe WAN-Leitung gekappt wird?
Prüfen Sie schonungslos, ob Ihre lokalen Produktions-, Klinik- oder Filialsysteme bei einem Ausfall der Internet- oder MPLS-Anbindung wirklich autark weiterlaufen oder ob nach wenigen Stunden zentrale Cloud-Authentifizierungs-Tokens, Lizenzserver oder API-Abhängigkeiten den Standort stilllegen.
2. Wie hoch sind unsere jährlichen Egress- und WAN-Bandbreitenkosten für unkomprimierte Standortdaten?
Lassen Sie sich vom Controlling aufschlüsseln, welcher Anteil Ihrer monatlichen Cloud-Rechnung auf den reinen Transport und die Rohdatenspeicherung von Sensor-, Video- oder Logdaten entfällt, die durch eine Vorfilterung am Netzwerkrand um über 90 Prozent reduziert werden könnten.
3. Besitzen wir auf unseren Edge-Systemen uneingeschränkte Root- und Hardware-Hoheit?
Klären Sie vor der Unterschrift unter proprietäre Appliance-Verträge, ob Ihre eigene Sicherheitsabteilung im Ernstfall direkten Zugriff auf Kernel-Logs, Netzwerk-Paketschnitte und Firmware-Stände hat oder ob Sie bei Sicherheitsvorfällen vollständig auf die Ticket-Bearbeitung eines außereuropäischen Cloud-Anbieters angewiesen sind.
4. Können wir jeden Standort ohne geschultes IT-Personal vor Ort rein deklarativ neu aufsetzen?
Eine verteilte Architektur mit zwanzig oder hundert Lokationen rechnet sich nur dann, wenn kein Administrator physisch zu den Standorten reisen muss. Stellen Sie sicher, dass Ihr Ziel-Stack Zero-Touch-Onboarding, unveränderbare Betriebssystem-Images mit automatischem Rollback bei fehlerhaften Updates und ein zentrales GitOps-Pull-Modell unterstützt.
5. Erfüllt unsere verteilte Datenverarbeitung nachweislich DORA Artikel 28 und den EU Data Act?
Verifizieren Sie gemeinsam mit der Rechts- und Compliance-Abteilung, dass sämtliche auf den Edge-Knoten eingesetzten Orchestrierungs- und Speicherformate auf offenen Standards (OCI, CNCF Kubernetes, S3/POSIX) beruhen, sodass ein Wechsel des Infrastruktur- oder Wartungspartners jederzeit ohne Datenverlust vollzogen werden kann.
Strategisches Fazit: Föderierte Souveränität statt verteilter Abhängigkeit
Der Übergang zu verteilten Cloud-Computing-Diensten markiert eine der wichtigsten Weichenstellungen der modernen Enterprise-IT. Er beendet das Zeitalter starrer Zentralisierung und bringt Rechenleistung, KI-Inferenz und Datenhaltung exakt dorthin, wo die reale Wertschöpfung im Unternehmen stattfindet: in die Fabrikhalle, in das Klinikum und an den regionalen Netzwerkrand.
Entscheidend für den langfristigen Erfolg ist jedoch die Wahl der Kontrollarchitektur. Wer proprietäre Edge-Appliances globaler Hyperscaler in seine Standorte stellt, importiert das Preisdiktat und die Ausfallrisiken der Public Cloud direkt in sein Kerngeschäft. Wer hingegen auf föderierte Open-Source-Control-Planes mit Cluster API, Karmada, Rancher und Cilium setzt, verbindet Cloud-Bedienkomfort mit Offline-Autarkie, über 68 Prozent niedrigeren Gesamtkosten und europäischer Datenhoheit.
Häufig gestellte Fragen (FAQ) zu verteilten Cloud-Computing-Diensten
Worin liegt der genaue architektonische Unterschied zwischen Edge Computing und einer Distributed Cloud?
Klassisches Edge Computing beschreibt zunächst nur die Platzierung einzelner Rechensysteme nahe an der Datenquelle, was häufig zu isolierten Administrations-Silos führt. Eine Distributed Cloud nach Gartner- und NIST-Definition verbindet diese dezentralen Ausführungsorte mit einer einheitlichen, föderierten Control Plane, sodass Sicherheitsrichtlinien, Updates und Observability über alle Standorte hinweg zentral per GitOps orchestriert werden.
Warum fallen proprietäre Appliances wie AWS Outposts oder Azure Local bei längeren Verbindungsabbrüchen oft aus?
Weil ihre primäre Steuerungsebene (Control Plane) sowie das Identity- und Schlüsselmanagement weiterhin in der zentralen Public-Cloud-Region des Anbieters liegen. Dauert eine WAN-Störung länger als die Gültigkeit der lokal zwischengespeicherten Sicherheits-Tokens, blockieren die Systeme lokale Konfigurationsänderungen, Skalierungen oder das Neustarten ausgefallener Dienste.
Wie gewährleistet ein offener Stack aus K3s, Karmada und ArgoCD den unterbrechungsfreien Inselbetrieb?
Jeder Standort betreibt mit K3s oder RKE2 einen vollständigen, eigenständigen Kubernetes-API-Server inklusive lokalem Zustandsspeicher und einer lokalen Container-Registry. Gleichzeitig arbeitet ArgoCD nach dem Pull-Prinzip vor Ort: Bei einem Verbindungsabbruch zur Zentrale steuert das lokale Cluster alle Workloads und Failover-Prozesse zeitlich unbegrenzt selbstständig weiter.
Wie werden hunderte verteilte Standorte ohne teure MPLS-Leitungen sicher miteinander vernetzt?
Durch den Einsatz von Cilium Cluster Mesh auf Basis von eBPF im Linux-Kernel in Kombination mit VXLAN-Overlays (RFC 7348) und Kernel-integrierter WireGuard-Verschlüsselung. Dienste können dadurch standortübergreifend über beliebige Internet- oder Glasfaserleitungen mit kryptografisch geprüften SPIFFE-Identitäten sicher und mit minimaler Latenz kommunizieren.
Welche regulatorischen Vorteile bietet eine souveräne Distributed Cloud unter DSGVO und DORA?
Sensible Rohdaten aus Kliniken, Produktionswerken oder Bankfilialen werden lokal verarbeitet und verlassen den Rechtsraum des Standorts nicht, was Drittlandtransfer-Risiken nach DSGVO ausschließt. Zudem vermeidet die offene CNCF-Architektur das nach DORA Artikel 28 kritische Konzentrationsrisiko bei außereuropäischen Cloud-Monopolisten und sichert die nach dem EU Data Act geforderte Wechselbarkeit.
Auditierbare Primärquellen & Technische Referenzen
| Institution & Herausgeber | Primärquelle & Normdokument | Architektonische Relevanz für den CIO |
|---|---|---|
| Cloud Native Computing Foundation (CNCF) | CNCF Cloud Native Architecture & Multi-Cluster Standards ↗ | Referenzarchitektur für herstellerneutrale Kubernetes-Orchestrierung, Karmada-Föderation, ArgoCD-GitOps und eBPF-basiertes Cilium-Networking. |
| Internet Engineering Task Force (IETF) | IETF RFC 7348 (Virtual eXtensible Local Area Network) ↗ | Protokollspezifikation für skalierbare Layer-2-Overlay-Netzwerke über Layer-3-Fabrics zur Kopplung verteilter Cloud- und Edge-Cluster. |
| Europäische Union (Amtsblatt EUR-Lex) | Verordnung (EU) 2023/2854 (EU Data Act) ↗ | Verbindliche Vorgaben zur Beseitigung technischer Wechselhürden, Interoperabilität von Datenverarbeitungsdiensten und Abschaffung von Egress-Strafgebühren. |
| Europäische Union (Amtsblatt EUR-Lex) | Verordnung (EU) 2022/2554 (DORA Art. 28) ↗ | Regulatorische Pflicht zur Begrenzung von IKT-Drittparteien- und Konzentrationsrisiken sowie zum Vorhalten getesteter technischer Ausstiegspläne. |
| Bundesamt für Sicherheit in der Informationstechnik (BSI) | BSI IT-Grundschutz-Kompendium (SYS.1.6 & OPS.2.2) ↗ | Sicherheitsanforderungen für Container-Orchestrierung, strikte Trennung der Management-Netze und abhörsichere Standortkopplung. |
*Modellrechnung: Alle angegebenen Lizenz-, Infrastruktur- und TCO-Werte verstehen sich als unverbindliche Beispielkalkulation auf Basis typischer Szenarien.
**Verweise auf Gesetzestexte, Paragrafen (u. a. DSGVO, NIS-2, EU AI Act, DORA, GoBD, BetrVG) und Compliance-Normen dienen ausschließlich der unverbindlichen technischen Fachinformation für IT-Entscheider. Sie stellen keine Rechtsberatung nach dem Rechtsdienstleistungsgesetz (RDG) dar; für eine rechtsverbindliche Beurteilung Ihrer spezifischen Unternehmensorganisation konsultieren Sie bitte Ihren Rechtsbeistand oder Datenschutzbeauftragten.

DAS CxO-PARADOX
Wie falsche digitale Souveränität Wirtschaft und Staat entkernt und wie echte Unabhängigkeit gelingt.
Von Mathias Diwo · Executive Tech Advisor
- ✓ 6-Hebel-Plan: Geordneter Ausstieg aus VMware- & Hyperscaler-Lock-ins
- ✓ Board Scorecard: One-Page IT-Governance für Vorstand & Aufsichtsrat
- ✓ Sofort lesbar: Vollständiges Kapitel 1 als Vorab-Dossier
Strategische Vertiefung im gleichen Themencluster
Weiterführende Architektur- und Handlungsleitfäden für CIOs & IT-Entscheider.

5-Jahres-TCO-Vergleich: RZ-Eigenbetrieb vs. Hyperscaler ab 100 Servern
Öffentliche Cloud-Plattformen versprechen finanzielle Elastizität, entwickeln sich bei konstanten 24/7-Workloads jedoch zur kostspieligen Dauerbelastung. Dieser Leitfaden vergleicht die Vollkosten über 60 Monate und zeigt den Architekturpfad zu AMD EPYC, KVM und Ceph im Colocation-Eigenbetrieb.

Post-Mortem einer Cloud-Migration: Lift-and-Shift-Sanierung und Repatriation
Wenn unreflektierte Lift-and-Shift-Migrationen zu explodierenden IOPS-, Inter-AZ- und Egress-Rechnungen führen, braucht die IT-Leitung einen präzisen Sanierungsplan. Dieser Leitfaden analysiert die architektonischen Ursachen und zeigt den 90-Tage-Pfad zur Entkopplung und Repatriation.

Mathias Diwo
Herausgeber & Executive Tech AdvisorGründer von TechNavigator.de, Buchautor (HYBRID WORK) und strategischer Beirat für CIOs und Vorstände. Begleitet mittelständische Konzerne und Verwaltungsorganisationen bei Cloud-Exit-Strategien, NIS-2 Haftungsschutz und digitaler Souveränität.