Verwaltete KI-Inferenz in der EU: Souveräne LLM-Nutzung am Beispiel IONOS AI Model Hub
Das Wichtigste in Kürze
- ✓Rechts- und Datensouveränität ohne US CLOUD Act**: Verwaltete Inferenzdienste europäischer Anbieter, etwa IONOS AI Model Hub, STACKIT AI Model Serving oder OVHcloud AI Endpoints, betreiben Open-Weights-Modelle in europäischen Rechenzentren unter europäischer Jurisdiktion; Zertifikate und Testate sind je Anbieter und Dienst zu prüfen.
- ✓Zero-Data-Retention und zustandsfreie Inferenz: Nach Anbieterangaben werden weder Prompts noch generierte Antworten oder hochgeladene RAG-Dokumente zum Training von Basismodellen gespeichert oder an Dritte weitergeleitet; diese Zusagen sollten vertraglich festgehalten und geprüft werden.
- ✓OpenAI-kompatible REST-Endpunkte für nahtlose Migration: Da viele dieser Dienste, darunter der IONOS AI Model Hub, dem OpenAI-API-Schema folgen, können bestehende Enterprise-Anwendungen, LangChain-Pipelines und AI-Gateways mit überschaubarem Aufwand durch Austausch der Base-URL auf deutsche Server umgestellt werden; Tests von Prompt-Verhalten und Ausgabequalität bleiben dennoch nötig.
- ✓Kalkulierbare Token-Preise ohne eigene GPU-Investition (CapEx): Für den deutschen Mittelstand schließt Managed-EU-Inferenz die wirtschaftliche Lücke zwischen datenschutzrechtlich bedenklichen US-KI-Abos und dem kostspieligen Eigenbetrieb dedizierter NVIDIA-H100-Servercluster.
Für IT-Entscheider, Datenschutzbeauftragte und Vorstände im europäischen Mittelstand gleicht die Einführung generativer Künstlicher Intelligenz oft einer Gratwanderung zwischen Innovationsdruck und regulatorischem Risiko. Einerseits verlangen Fachabteilungen leistungsfähige Sprachmodelle für die Dokumentenanalyse, den Kundenservice und die Softwareentwicklung; andererseits verbieten DSGVO, Geschäftsgeheimnisgesetz (GeschGehG) und branchenspezifische Vorgaben den unkontrollierten Abfluss sensibler Unternehmensdaten in außereuropäische Cloud-Plattformen.
Gleichzeitig ist der Aufbau eigener GPU-Rechenzentren für viele mittelständische Unternehmen mit 100 bis 1.000 Mitarbeitenden wirtschaftlich kaum darstellbar, wenn die teuren Beschleunigerkarten nachts und am Wochenende ungenutzt leerlaufen. Diese Lücke adressieren verwaltete europäische Serverless-Inferenzdienste. Der Beitrag ordnet die Kategorie ein und nutzt den IONOS AI Model Hub als Beispiel; vergleichbare Angebote sind etwa STACKIT AI Model Serving oder OVHcloud AI Endpoints. Angaben zu einzelnen Diensten beruhen auf Herstellerdokumentation.
Architektur verwalteter EU-Inferenz am Beispiel des IONOS AI Model Hub
Technisch stellt ein solcher Dienst eine mandantenfähige Inference-as-a-Service-Schicht auf GPU-Clustern des Anbieters bereit; beim IONOS AI Model Hub erfolgt die Verarbeitung nach Herstellerangaben in Deutschland. Statt selbst virtuelle Maschinen mit GPU-Passthrough, CUDA-Treibern und vLLM-Containern administrieren zu müssen, konsumieren Entwicklungsteams kuratierte Open-Source-Spitzenmodelle direkt über eine gehärtete HTTPS-REST-API.
Typisch sind vier Leistungsbausteine, hier nach der Dokumentation des IONOS AI Model Hub:
- Kuratierte Open-Weights-Modellbibliothek: Bereitstellung verbreiteter Sprachmodelle (etwa der Familien Meta Llama, Mistral und Mixtral in verschiedenen Parametergrößen) für Textgenerierung, Zusammenfassung, Übersetzung und strukturiertes Function Calling.
- Native Embedding- und RAG-Pipeline: Über integrierte Embedding-Modelle und Dokumentensammlungen in einer Vektordatenbank lassen sich unternehmenseigene PDF-Handbücher, Richtlinien und Produktkataloge ohne Drittanbieter-Datenbank semantisch durchsuchbar machen.
- OpenAI-SDK-Kompatibilität: Da die Endpunkte für Chat-Completions und Embeddings der OpenAI-Spezifikation folgen, lassen sich Standard-Frameworks wie Open WebUI, LibreChat, LangChain, LlamaIndex oder n8n meist ohne größere Quellcode-Änderungen anbinden.
- Multimodale Bildgenerierung: Neben reinen Text- und Code-Modellen bietet die Plattform hochauflösende Text-zu-Bild-Generierung auf Basis offener Diffusionsmodelle für Marketing- und Designabteilungen.
Architektonischer Blindspot: US-Töchter mit EU-Rechenzentrum vs. echte EU-Jurisdiktion
Viele Unternehmen wiegen sich in falscher Sicherheit, wenn ein US-Hyperscaler die Modellverarbeitung in der Region „Frankfurt“ oder „EU-West“ anbietet. Da US-Konzerne und ihre europäischen Tochtergesellschaften jedoch dem US CLOUD Act unterliegen, können amerikanische Behörden auch die Herausgabe von auf deutschen Servern gespeicherten Daten erzwingen. Echte Rechtssouveränität entsteht erst, wenn auch der Plattformbetreiber selbst ausschließlich deutschem und europäischem Recht untersteht.
Einen umfassenden Überblick über alle verfügbaren Sprachmodell-Familien und deren Lizenzbedingungen bietet der Grundlagen-Leitartikel zu Enterprise KI-Modellen, Open-Weights-Architekturen und Benchmark-Metriken.
Ergänzende Architektur-Analysen und technische Entscheidungsmatrizen für die IT-Planung finden sich in den weiterführenden Beiträgen zu Enterprise KI-Strategie im Enterprise-Einsatz, zu Anthropic Claude im Enterprise-Einsatz sowie zu Perplexity Enterprise im Enterprise-Einsatz.
Einsatzszenarien im Mittelstand: Vom souveränen Mitarbeiter-Chatbot bis zur Fach-Automatisierung
In der betrieblichen Praxis entfalten solche Dienste ihren größten Nutzen dort, wo vertrauliche Unternehmensdaten verarbeitet werden müssen, ohne dass eine eigene rund um die Uhr betreute GPU-Infrastruktur aufgebaut werden soll:
- Souveränes ChatGPT-Äquivalent für die Belegschaft: Durch die Kombination einer selbst gehosteten Oberfläche wie Open WebUI (auf einer kleinen Linux-VM) mit einem EU-Inferenzdienst als Backend-API lässt sich mit überschaubarem Aufwand ein KI-Arbeitsplatz für die Belegschaft ohne Pro-Kopf-Abonnementkosten bereitstellen.
- Automatisierte Triage im Kundenservice und ITSM: Eingehende Support-Tickets, Schadensmeldungen oder Lieferantenanfragen werden über die API automatisch klassifiziert, mit passenden Lösungsartikeln aus der internen Vektordatenbank angereichert und als Antwortentwurf im ERP- oder Ticketsystem bereitgestellt.
- DSGVO-konforme Dokumentenextraktion: Verträge, Lieferscheine und technische Spezifikationen werden in strukturierte JSON-Objekte überführt, ohne dass personenbezogene Daten den deutschen Rechtsraum verlassen.
„Für einen großen Teil der betrieblichen Text-, Zusammenfassungs- und RAG-Aufgaben benötigen Unternehmen kein proprietäres US-Frontier-Modell, sondern ein sauber in deutsche Rechenzentren eingebettetes Open-Weights-Sprachmodell.“
Wie sich verschiedene Sprachmodelle und lokale Endpunkte über eine zentrale Steuerungsschicht bündeln lassen, zeigt der Leitfaden zu KI im Unternehmen und zentraler KI-Steuerung.
System-Matrix: Verwaltete EU-Inferenz vs. US-Hyperscaler-KI vs. On-Premises-GPU-Cluster
Die folgende Übersicht vergleicht drei verbreitete Bereitstellungsmodelle für generative KI im Enterprise-Einsatz:
| Architektur-Kriterium | US-Hyperscaler LLM-APIs (OpenAI / Azure / AWS) | Managed EU-Inferenz (z. B. IONOS AI Model Hub) | Strategische Einordnung |
|---|---|---|---|
| Rechtsraum & Souveränität | US-Konzernmutter unterliegt dem US CLOUD Act, auch bei Serverstandort Frankfurt. | Europäischer Betreiber; Zertifikate und Testate (z. B. ISO 27001, BSI C5) je Dienst prüfen. | EU-Rechtsrahmen |
| Kostenmodell & Skalierung | Nutzungsbasierte Token-Preise oder Named-User-Abos mit festen Monatsgebühren pro Nutzer. | Überwiegend nutzungsbasierte Abrechnung pro Token, in der Regel ohne Pro-Kopf-Lizenzen. | Nutzungsbasierte Kosten |
| Modelltransparenz & Portabilität | Überwiegend geschlossene Modelle; ein Wechsel auf eigenes Hosting desselben Modells ist meist nicht möglich. | Offene Modelle (etwa Llama, Mistral); grundsätzlich auch auf eigenen GPUs betreibbar. | Geringer Vendor-Lock-in |
| Integrierte RAG-Vektordatenbank | Erfordert separate kostenpflichtige Zusatzdienste (z. B. Azure AI Search) mit komplexem Pricing. | Je nach Dienst integrierte Dokumentensammlungen und Vektorsuche (beim IONOS AI Model Hub laut Dokumentation vorhanden). | Schneller RAG-Rollout |
Make-or-Buy & Kostentreiber: Named-User-KI-Suite vs. EU-Inferenz-API + Open WebUI
Deutlich wird der Unterschied einer nutzungsbasierten europäischen API, wenn ein Unternehmen mit 300 Büroarbeitsplätzen allen Mitarbeitenden Zugang zu generativer KI und interner Dokumentensuche gewähren möchte, die tatsächliche Nutzungsintensität im Arbeitsalltag jedoch stark variiert.
Ein TCO-Vergleich über drei Jahre zeigt, wovon die Kosten abhängen:
- Proprietäre Named-User-KI-Lizenzen: Selbst wenn ein großer Teil der Belegschaft die KI nur wenige Male pro Woche nutzt, fallen über die Laufzeit starre Lizenzgebühren pro Kopf an, zuzüglich des Aufwands für die Berechtigungsbereinigung und Datenschutz-Folgenabschätzung.
- Souveräner Stack (Open WebUI + EU-Inferenz-API mit Token-Abrechnung): Der Betrieb einer dedizierten Open-WebUI-Instanz inklusive Single-Sign-On sowie das tatsächliche Token-Volumen bestimmen hier die Kosten. Bei ungleichmäßiger Nutzung fällt die Rechnung häufig deutlich günstiger aus als bei Pro-Kopf-Lizenzen; hinzu kommen Aufwände für Betrieb, Pflege und Support der eigenen Oberfläche. Das Unternehmen behält zudem die Kontrolle über die Prompts.
4-Phasen-Rollout-Roadmap für verwaltete EU-Inferenz im Unternehmen
Die produktive Einführung einer europäischen KI-Inferenzarchitektur gelingt in vier strukturierten Phasen:
- Phase 1 (Woche 1 bis 3): AVV-Abschluss und API-Gateway-Setup. Abschluss des Vertrags zur Auftragsverarbeitung (AVV) nach Art. 28 DSGVO mit dem gewählten Anbieter; Einrichtung dedizierter API-Keys pro Fachabteilung oder Kostenstelle und Anbindung an ein zentrales internes AI-Gateway (z. B. LiteLLM).
- Phase 2 (Woche 4 bis 6): Bereitstellung des internen KI-Arbeitsplatzes. Installation von Open WebUI oder LibreChat im eigenen Firmennetzwerk mit Anbindung an Active Directory / Entra ID / Authentik und Hinterlegung der gewählten Modell-Endpunkte als Standardmodelle.
- Phase 3 (Monat 2 bis 4): Aufbau abteilungsspezifischer RAG-Wissenssammlungen. Indexierung freigegebener Unternehmensdokumente (IT-Handbücher, Qualitätsmanagement-Richtlinien, Produktdatenblätter) über die Embedding-API und Bereitstellung spezialisierter Wissensassistenten.
- Phase 4 (Ab Monat 5): Integration in Fachprozesse und hybrides Fallback-Routing. Einbettung der REST-API in Ticketsysteme, ERP-Workflows und Dokumentenverarbeitung; bei steigender Dauerlast kann ein Teil der Workloads mit überschaubarem Aufwand auf eigene dedizierte GPU-Server verlagert werden.
5 C-Level-Kontrollfragen für CIOs und Datenschutzbeauftragte
1. Warum zahlen wir pauschale monatliche Pro-Kopf-KI-Gebühren für hunderte Mitarbeitende, statt nur die tatsächlich verbrauchten API-Tokens abzurechnen?
Prüfen Sie Ihre reale Token-Auslastung: Bei ungleichmäßiger Nutzung ist eine zentrale Oberfläche mit nutzungsbasierter API-Abrechnung häufig deutlich günstiger als starre Seat-Lizenzen; Betrieb und Support der eigenen Oberfläche sind einzurechnen.
2. Unterliegt unser aktueller KI-Infrastrukturbetreiber ausschließlich europäischer Gerichtsbarkeit oder greift im Ernstfall der US CLOUD Act?
Verlangen Sie für Geschäftsgeheimnisse, F&E-Daten und Personaldokumente eine Infrastruktur, deren Muttergesellschaft ihren Sitz in der Europäischen Union hat.
3. Sind unsere KI-Anwendungen über den OpenAI-kompatiblen API-Standard so gekapselt, dass wir das Sprachmodell kurzfristig wechseln können?
Vermeiden Sie proprietäre Hersteller-SDKs im Anwendungscode. Über standardisierte REST-Endpunkte bleiben Sie jederzeit frei in der Wahl zwischen EU-Cloud-Inferenz und eigenem Rechenzentrum.
4. Haben wir vertraglich und technisch sichergestellt, dass keiner unserer Prompts oder RAG-Kontexte nach Beendigung des API-Aufrufs gespeichert bleibt?
Achten Sie auf vertraglich dokumentierte Zero-Data-Retention-Zusagen (zustandslose Verarbeitung im flüchtigen VRAM ohne Log-Speicherung der Nutzdaten).
5. Ab welchem monatlichen Token-Volumen lohnt sich der Übergang von Serverless-API-Inferenz auf dedizierte eigene GPU-Hardware?
Überwachen Sie Ihre monatlichen API-Rechnungen im AI-Gateway: Solange die monatlichen Token-Kosten unter den Abschreibungs- und Stromkosten eines eigenen GPU-Clusters liegen, ist Serverless-EU-Inferenz in der Regel die wirtschaftlichere Wahl.
Einordnung: Verwaltete EU-Inferenz als pragmatischer Zwischenweg
Angebote wie der IONOS AI Model Hub zeigen, dass hohe europäische Datenschutz- und Souveränitätsansprüche nicht zwingend hohe Hardware-Einstiegshürden bedeuten. Die Kombination aus europäischen Rechenzentren, Open-Weights-Modellen und OpenAI-kompatiblen APIs ist eine Option unter mehreren europäischen Anbietern; ihre Eignung ist im Einzelfall anhand von Verträgen, Modellangebot und Kosten zu prüfen.
Häufig gestellte Fragen (FAQ) zu verwalteter EU-Inferenz und zum IONOS AI Model Hub
Welche KI-Modelle stehen im IONOS AI Model Hub zur Verfügung?
Nach Herstellerangaben bietet die Plattform wechselnde Open-Weights-Sprachmodelle verschiedener Familien und Größen, Embedding-Modelle für Vektorsuchen sowie Text-zu-Bild-Modelle. Das aktuelle Angebot ist der Modellliste in der Dokumentation zu entnehmen.
Werden eingegebene Unternehmensdaten bei IONOS für das KI-Training verwendet?
Nach Herstellerangaben bleiben Eingabedaten ausschließlich zur Nutzung durch den Kunden und werden nicht zum Training verwendet; die Verarbeitung erfolgt in Deutschland. Zu Speicherdauer und Protokollierung von Prompts macht die öffentliche Produktbeschreibung keine näheren Angaben; diese Punkte gehören in den Vertrag zur Auftragsverarbeitung.
Wie aufwendig ist die Umstellung einer bestehenden OpenAI-Anwendung auf den IONOS AI Model Hub?
Da der IONOS AI Model Hub eine OpenAI-kompatible REST-Schnittstelle bereitstellt, müssen Entwickler im bestehenden Programmcode lediglich die Basis-URL (Endpoint) und den API-Schlüssel sowie den gewünschten Modellnamen anpassen. Der übrige Code bleibt in der Regel unverändert; Prompt-Verhalten und Ausgabequalität sollten dennoch getestet werden.
Wie funktioniert Retrieval-Augmented Generation (RAG) im IONOS AI Model Hub?
Unternehmen können über die Document-Collection-API eigene Textabschnitte hochladen. Die Plattform wandelt diese Dokumente automatisch mithilfe von Embedding-Modellen in mathematische Vektoren um und speichert sie in einer deutschen Vektordatenbank. Bei einer Nutzeranfrage werden die relevantesten Textstellen abgerufen und dem Sprachmodell als verlässlicher Kontext übergeben.
Über welche Sicherheitszertifizierungen verfügen die Rechenzentren von IONOS?
Nach Anbieterangaben sind die deutschen Rechenzentren von IONOS nach ISO/IEC 27001 zertifiziert und verfügen über ein BSI-C5-Testat (Cloud Computing Compliance Criteria Catalogue des Bundesamts für Sicherheit in der Informationstechnik), was eine gute Grundlage für Compliance-Anforderungen des gehobenen Mittelstands und des öffentlichen Sektors bietet; die Prüfung im Einzelfall ersetzt das nicht.
Primärquellen & Regulatorische Evidenz
| Quelle / Institution | Dokument / Standard | Kernaussage & Architektur-Relevanz | Verifikation |
|---|---|---|---|
| BSI (Bundesamt für Sicherheit in der Informationstechnik) | Kriterienkatalog C5 (Cloud Computing Compliance Criteria Catalogue) & KI-Sicherheit | Prüfstandard für Informationssicherheit, Standorttransparenz und Mandantentrennung im professionellen Cloud-Betrieb. | BSI-Standard prüfen |
| Europäische Union (EUR-Lex) | DSGVO (EU) 2016/679 (Kapitel V Drittlandtransfer) & EU AI Act (EU) 2024/1689 | Rechtliche Anforderungen an die Verarbeitung personenbezogener Daten innerhalb der EU und Governance für Allzweck-KI-Modelle (GPAI). | EU-Rechtsakt einsehen |
| NIST (National Institute of Standards and Technology) | NIST AI Risk Management Framework (AI RMF 1.0) & SP 800-218A | Sicherheits- und Governance-Vorgaben für die Einbindung von Open-Weights-Sprachmodellen und RAG-Architekturen. | NIST-Publikation abrufen |
| IONOS (Herstellerangabe) | AI Model Hub – Overview (Produktdokumentation, Stand Oktober 2026) | Herstellerbeschreibung: OpenAI-kompatible Endpunkte, Dokumentensammlungen für RAG, Verarbeitung in Deutschland, kein Training mit Kundendaten. | Dokumentation öffnen |
*Modellrechnung: Alle angegebenen Lizenz-, Infrastruktur- und TCO-Werte verstehen sich als unverbindliche Beispielkalkulation auf Basis typischer Szenarien.
**Verweise auf Gesetzestexte, Paragrafen (u. a. DSGVO, NIS-2, EU AI Act, DORA, GoBD, BetrVG) und Compliance-Normen dienen ausschließlich der unverbindlichen technischen Fachinformation für IT-Entscheider. Sie stellen keine Rechtsberatung nach dem Rechtsdienstleistungsgesetz (RDG) dar; für eine rechtsverbindliche Beurteilung Ihrer spezifischen Unternehmensorganisation konsultieren Sie bitte Ihren Rechtsbeistand oder Datenschutzbeauftragten.

DAS CxO-PARADOX
Wie falsche digitale Souveränität Wirtschaft und Staat entkernt und wie echte Unabhängigkeit gelingt.
Von Mathias Diwo · Executive Tech Advisor
- ✓ 6-Hebel-Plan: Geordneter Ausstieg aus VMware- & Hyperscaler-Lock-ins
- ✓ Board Scorecard: One-Page IT-Governance für Vorstand & Aufsichtsrat
- ✓ Sofort lesbar: Vollständiges Kapitel 1 als Vorab-Dossier
Strategische Vertiefung im gleichen Themencluster
Weiterführende Architektur- und Handlungsleitfäden für CIOs & IT-Entscheider.
Welche Regeln gelten für ChatGPT – DSA oder AI Act? Eine Zuordnung für Unternehmen, die es einsetzen
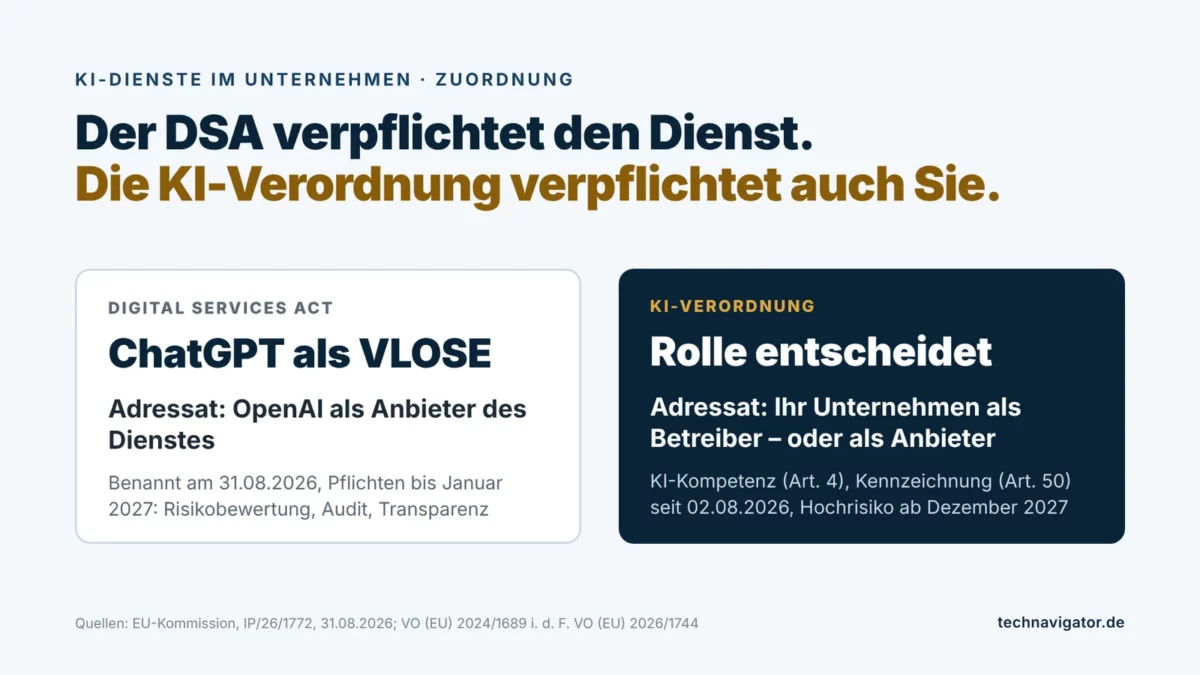
Seit Ende August 2026 steht ChatGPT unter der strengsten Aufsicht des Digital Services Act, doch diese Pflichten treffen den Anbieter, nicht das Unternehmen, das den Dienst nutzt. Für das einsetzende Unternehmen entscheidet die KI-Verordnung, und dort hängt alles an der Rolle: Betreiber oder Anbieter.
Sieben KI-Fabriken für Europa: Wer wird dort Kunde?
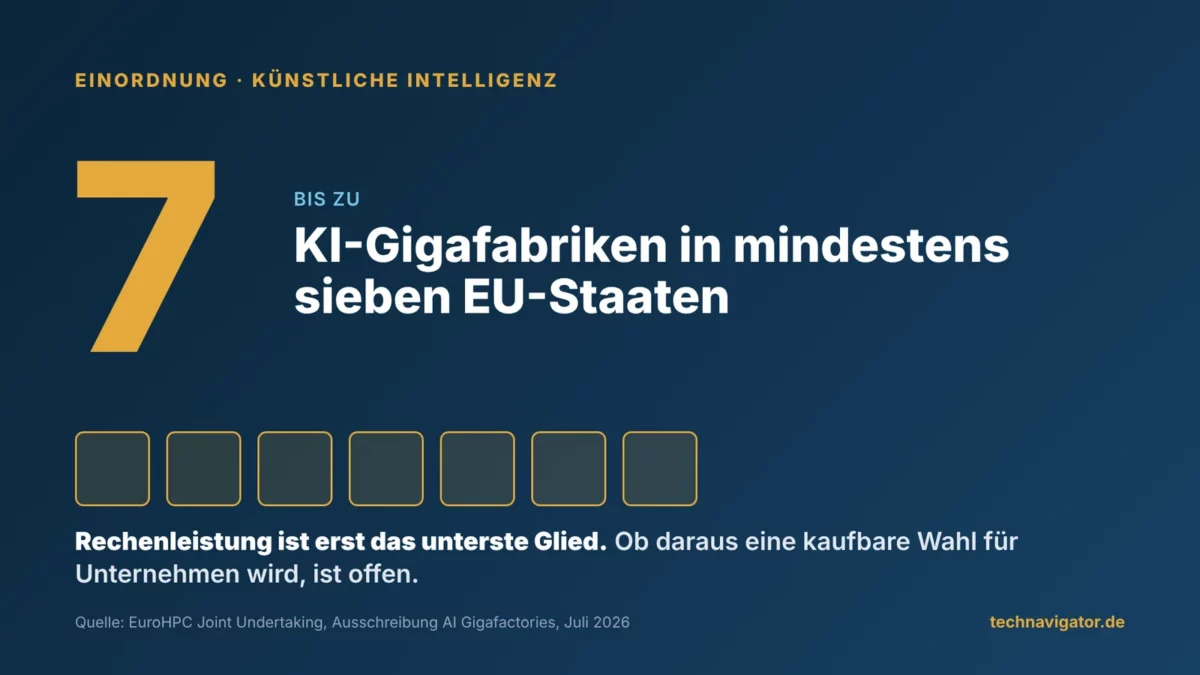
Am 12. November endet die EU-Ausschreibung für bis zu sieben KI-Gigafabriken. Für Unternehmen im DACH-Raum zählt weniger die Rechenleistung als die Frage, ob daraus ein kaufbares Angebot wird. Eine Einordnung.
Mathias Diwo
Herausgeber & Executive Tech AdvisorGründer von TechNavigator.de, Buchautor (HYBRID WORK) und strategischer Beirat für CIOs und Vorstände. Begleitet mittelständische Konzerne und Verwaltungsorganisationen bei Cloud-Exit-Strategien, NIS-2 Haftungsschutz und digitaler Souveränität.