Die 4 Arten von KI: Klassische Einteilung und Architekturstufen für die Unternehmens-IT
Das Wichtigste in Kürze
- ✓Vierstufige Architektur-Hierarchie: Die technologische Evolution spannt sich von zustandslosen Regelsystemen über speichergestützte Foundation Models und Multi-Agenten bis zu autonom reflektierenden Reasoning-Clustern.
- ✓KV-Cache und Memory-Bottlenecks: Der sprunghafte Anstieg des HBM-Speicherbedarfs bei langen Kontexten zwingt Rechenzentren zur präzisen Trennung deterministischer und probabilistischer Inferenzpfade.
- ✓Wirtschaftliche TCO*-Diskrepanz: Unkontrollierte API-Token-Abfragen vervielfachen laufende Betriebskosten, während eigene Inferenz-Plattformen mit offenen Modellen bei hohem, stetigem Volumen wirtschaftlich arbeiten können.
- ✓Regulatorische Konformität nach EU AI Act**: Die Pflichten richten sich nach Einsatzzweck und Risikoklasse, nicht nach der Architekturstufe; Hochrisiko-Anwendungen verlangen unter anderem Risikomanagement, Protokollierung und menschliche Aufsicht sowie klare organisatorische Kontrollgrenzen.
Die Debatte um künstliche Intelligenz in europäischen Unternehmen leidet häufig unter einer unpräzisen Begriffswelt. Wo Marketingabteilungen und Plattformanbieter jeden Algorithmus pauschal als intelligente Gesamtlösung deklarieren, müssen Systemarchitekten nüchterne technische Differenzierungen vornehmen. Ein starres Regelwerk stellt fundamental andere Anforderungen an Latenz, Rechenleistung und Speicherbandbreite als ein mehrstufig reflektierendes Sprachmodell.
Historisch betrachtet reicht das Spektrum von den mathematischen Pionierarbeiten Alan Turings bis zu modernen Rechenclustern mit hunderten vernetzter Beschleunigerkarten. Unternehmen stehen heute vor der Herausforderung, ihre betrieblichen Workloads den passenden technologischen Reifegraden zuzuordnen. Wer jeden Prozessschritt reflexartig an externe Sprachmodelle delegiert, riskiert stark steigende Token-Rechnungen und verfehlt zugleich elementare Anforderungen an Datenhoheit und Ausfallsicherheit.
Für IT-Leiter und Vorstände entsteht daraus die Notwendigkeit einer belastbaren Klassifizierung. Erst wenn die Grenzen zwischen reaktiven Mechanismen, zustandsbehafteten Foundation Models, kooperativen Agenten und souveränem Reasoning klar definiert sind, lassen sich Architekturen zukunftssicher planen. Dieser Leitfaden analysiert die vier Stufen künstlicher Intelligenz anhand harter Rechenzentrumsparameter und zeigt praxiserprobte Entscheidungskriterien für den betrieblichen Produktivbetrieb.
Der architektonische Scheideweg: Warum Corporate IT KI-Workloads klassifizieren muss
In den Rechenzentren der DACH-Region vollzieht sich derzeit eine fundamentale Verschiebung der IT-Ausgaben. Während klassische CPU-basierte Virtualisierungscluster über Jahre hinweg stetig optimiert wurden, erzwingt der Einzug generativer und kognitiver Systeme eine völlig neue Infrastrukturlogik. Hochparallele Beschleunigerchips, extrem schnelle Speicheranbindungen und spezifische Netzwerk-Fabrics verändern die Kostenstrukturen von Grund auf.
Ohne eine strukturierte Klassifizierung der Workloads droht Organisationen eine teure Fehlallokation wertvoller Ressourcen. Viele betriebliche Aufgabenstellungen wie formatgebundene Datenprüfungen, Stammdatenabgleiche oder numerische Berechnungen erfordern keinerlei statistische Wahrscheinlichkeitsmodelle. Wenn solche Workloads fälschlicherweise auf speicherhungrige Sprachmodelle umgeleitet werden, steigen Inferenzzeiten und Energieverbräuche ohne operativen Mehrwert.
Gleichzeitig steigen die regulatorischen Anforderungen an Nachvollziehbarkeit und Datenschutz stetig an. Der europäische Gesetzgeber knüpft Kontrollpflichten nicht an abstrakte Modellnamen, sondern an die tatsächliche Entscheidungsautonomie und das Risikopotenzial des eingesetzten Systems. Eine präzise Zuordnung zu den vier Architekturstufen erleichtert die anschließende Einstufung nach den Risikoklassen des EU AI Act, ersetzt sie aber nicht.
Architektonischer Blindspot: Unkontrollierte Modellüberdimensionierung bei banalen Standardprozessen
Viele Unternehmen leiten einfache Textfilter oder Stammdatenprüfungen unüberlegt an externe Hyperscaler-APIs weiter. Dies verursacht nicht nur vermeidbare Token-Rechnungen, sondern transferiert vertrauliche Unternehmensdaten ohne Not über Dritte. Ein optimiertes Regelwerk oder kompaktes On-Premises-System erledigt dieselbe Aufgabe oft deutlich schneller und hält die Daten im eigenen Verantwortungsbereich.
Wie sich diese Klassifizierung in eine übergeordnete IT-Roadmap einbettet, beschreibt die Analyse zur nachhaltigen unternehmensweiten KI-Strategie. IT-Verantwortliche gewinnen dadurch eine fundierte Argumentationsgrundlage gegenüber Fachbereichen, die oft unreflektiert nach den neuesten und teuersten Modellvarianten verlangen.
Ergänzende Architektur-Analysen und technische Entscheidungsmatrizen für die IT-Planung finden sich in den weiterführenden Beiträgen zu ChatGPT Enterprise im Enterprise-Einsatz sowie zu Künstliche Intelligenz im Enterprise-Einsatz.
Technischer Deep-Dive: Die 4 KI-Architekturstufen im Detail
Die verbreitete Einteilung in „vier Arten von KI“ geht auf einen Beitrag des Informatikers Arend Hintze aus dem Jahr 2016 zurück: reaktive Maschinen, Systeme mit begrenztem Gedächtnis, „Theory of Mind“ und Selbstbewusstsein. Nur die ersten beiden Typen existieren heute; die Typen drei und vier beschreiben hypothetische Fähigkeiten. Für die Planung im Rechenzentrum nutzt dieser Beitrag deshalb eine praxisbezogene Abwandlung: Die Stufen eins und zwei folgen der klassischen Einteilung, die Stufen drei und vier ordnen heute verfügbare Architekturen – Multi-Agenten-Systeme und Reasoning-Modelle – ein. Jede Stufe unterscheidet sich signifikant in Bezug auf Gedächtnisstrukturen, Lernmechanismen, Rechenkomplexität und die Fähigkeit zur Verallgemeinerung. Für das IT-Management entscheidet diese Zuordnung direkt über Hardware-Sizing, Software-Stack und Governance.
Stufe 1 und 2: Reaktive Heuristiken und transformatorische Kontextspeicher
Reaktive Systeme bilden das historische Fundament der Automatisierungstechnik. Diese Klasse verfügt über keinerlei internes Gedächtnis und speichert keine vergangenen Interaktionen. Auf jeden Eingabezustand folgt stets eine deterministische Reaktion, basierend auf festen Heuristiken oder statischen Entscheidungsbäumen. Prominente Beispiele sind frühe Schachcomputer wie Deep Blue oder regelbasierte Transaktionsfilter im Zahlungsverkehr.
Der große Vorteil reaktiver Architekturen liegt in ihrer absoluten Vorhersagbarkeit und ultrakurzen Latenz im Sub-Millisekundenbereich. Da keine probabilistischen Zwischenschritte stattfinden, existieren weder Halluzinationen noch statistische Verzerrungen. Die Grenzen sind jedoch ebenso eindeutig: Bei unbekannten Datenmustern versagt das System vollständig, da keine adaptive Generalisierung stattfinden kann.
Die zweite Architekturstufe, Systeme mit begrenztem Gedächtnis, dominiert die gegenwärtige KI-Landschaft. Hierunter fallen moderne Machine-Learning-Verfahren und vor allem die transformatorischen Basismodelle. Diese Architekturen verarbeiten Sequenzen historischer Daten und nutzen dynamische Aufmerksamkeitsmechanismen, um kontextbezogene Muster zu erkennen und Vorhersagen zu treffen.
„Die wahre Herausforderung im Enterprise-Betrieb besteht nicht darin, das größte verfügbare Sprachmodell einzubinden, sondern Workloads präzise auf die wirtschaftlich und regulatorisch passgenaue Architekturstufe zuzuschneiden.“
Der Speicherhunger dieser zweiten Stufe stellt Rechenzentren vor erhebliche Herausforderungen. Bei Sprachmodellen muss für jeden verarbeiteten Token der sogenannte Key-Value-Cache (KV-Cache) im extrem schnellen High-Bandwidth-Memory (HBM) der Beschleunigerkarten vorgehalten werden. Bei langen Dokumentenanalysen oder parallelen Anfragen wächst dieser Speicherbedarf linear mit der Kontextlänge und der Zahl paralleler Anfragen und begrenzt die Skalierbarkeit herkömmlicher GPU-Server.
Stufe 3 und 4: Multi-Agenten-Orchestrierung und Sovereign Reasoning
Die dritte Stufe umfasst in dieser Architektursicht koordinierte Agentensysteme. Mit der „Theory of Mind“ der klassischen Einteilung – einem echten Verständnis mentaler Zustände und Absichten – haben sie wenig gemein: Heutige Agenten modellieren Ziele und Zwischenstände technisch, ohne sie zu verstehen. Im Unternehmensumfeld zeigt sich diese Stufe in vernetzten Multi-Agenten-Systemen, die arbeitsteilig komplexe Workflows verhandeln und ausführen.
Kollaborative Agenten führen iterative Feedbackschleifen durch, rufen spezialisierte Tools über APIs auf und korrigieren eigene Zwischenschritte eigenständig. Für die IT-Architektur bedeutet dies eine Verlagerung weg von einzelnen Großmodellen hin zu flexiblen Orchestrierungsframeworks. Hierbei müssen strikte Berechtigungsgrenzen, State-Management und Timeouts definiert werden, um Endlosschleifen oder widersprüchliche Systementscheidungen auszuschließen.
Die vierte Stufe umfasst in dieser Architektursicht Reasoning-Modelle („Sovereign Reasoning“, wenn sie im eigenen Rechenzentrum betrieben werden). Sie ist nicht mit dem vierten Typ der klassischen Einteilung – maschinellem Selbstbewusstsein – zu verwechseln, den es nicht gibt. Während frühere Modelle Antworten rein probabilistisch Wort für Wort generierten, nutzen moderne Reasoning-Modelle dedizierte Denkphasen vor der Ausgabe. Diese Modelle explorieren verschiedene Lösungswege, widerlegen eigene Hypothesen und validieren logische Schlussfolgerungen systematisch über Chain-of-Thought-Prozesse.
Einen technologischen Meilenstein markieren hierbei offene Architekturen, wie sie in der Detailanalyse zur DeepSeek-Architektur dargelegt sind. Sie zeigen, dass hochgradig reflektierende Modelle ohne Abhängigkeit von einzelnen US-Plattformanbietern auf eigener Enterprise-Hardware betrieben werden können. Welche Leistungsklassen für spezifische Fachaufgaben infrage kommen, vertieft der Überblick zur Modellklassifizierung.
Architektur- und Leistungsvergleich: Die 4 KI-Stufen im Enterprise-Einsatz
Für Entscheidungen im Lenkungsausschuss müssen technische Fähigkeiten, Speichercharakteristika und wirtschaftliche Implikationen gegenübergestellt werden. Nicht jede betriebliche Herausforderung verlangt nach reflektierenden Modellen, während einfache Regelsysteme bei unstrukturierten Datenformaten an ihre Grenzen stoßen.
Die nachfolgende Vergleichsmatrix stellt die vier Architekturstufen anhand relevanter Enterprise-Kriterien gegenüber und ordnet sie aus Sicht der IT-Leitung ein:
| Architekturstufe | Funktionsprinzip & Speicher | Typische Enterprise-Workloads | CIO-Bewertung |
|---|---|---|---|
| 1. Reaktive Systeme (Heuristik) | Zustandslose Regelsysteme und Heuristiken ohne internes Gedächtnis oder Kontextspeicher. | Statische Compliance-Filter, deterministische Stammdatenprüfungen und numerische Berechnungen. |
DeterministischNull Halluzination
|
| 2. Begrenztes Gedächtnis (Transformer) | Probabilistische Vorhersage mit temporärem KV-Cache im schnellen Beschleunigerspeicher. | Semantische Suche, Dokumenten-Zusammenfassung, Parsing und Übersetzungsworkflows. |
HBM-intensivKV-Cache-Engpass
|
| 3. Multi-Agenten-Systeme (Orchestrierung) | Dynamische Intentions-Modellierung, Tool Calling und vernetztes Session-State-Management. | Arbeitsteilige Prozessketten, automatisierter Kundensupport und komplexe Recherchen. |
OrchestrierungState-Governance nötig
|
| 4. Reasoning-Modelle (Test-Time Compute) | Iterative Verifikationspfade, Test-Time-Compute-Skalierung und offene Inferenz-Stacks. | Code-Synthese, mathematische Optimierung, forensische Audits und juristische Analysen. |
RechenintensivOn-Premises-fähig
|
| Querschnitt: Hybrides Inferenz-Routing | Dynamischer Dispatcher zwischen Heuristik, SLM und High-End-Reasoning-Clustern. | Heterogene Enterprise-Workloads mit variabler Komplexität und strikten Latenzvorgaben. |
KostenoptimalMinimale Token-Last
|
Die tabellarische Gegenüberstellung verdeutlicht den Nutzen eines hybriden Routings. Statt sämtliche Anfragen an das teuerste Reasoning-Modell zu schicken, filtert eine vorgelagerte Heuristik banale Anfragen im Vorfeld heraus. Nur hochkomplexe Problemstellungen erreichen die rechenintensiven Stufen drei und vier.
Dieser abgestufte Aufbau sichert die Einhaltung harter Service-Level-Agreements. Während Fachanwender bei Dokumentenprüfungen Antwortzeiten unterhalb einer Sekunde erwarten, tolerieren sie bei tiefgehenden Marktanalysen oder Sicherheitsaudits durchaus mehrsekündige Bedenkzeiten eines reflektierenden Systems.
Vollkostenbetrachtung: TCO-Dynamik von API-Tokens bis Sovereign On-Premises
Die kaufmännische Tragweite architektonischer Weichenstellungen zeigt sich erst über mehrere Jahre. Maßgeblich sind das tägliche Inferenzvolumen, seine Verteilung über Dokumentenanalysen, interne Wissensabfragen, Übersetzungen und automatisierte Workflows sowie die Frage, wie stark dieses Volumen mit der Zahl der Nutzer wächst.
Wird dieser Bedarf vollständig über kommerzielle Hyperscaler-APIs bezogen, entstehen ausschließlich laufende Kosten, die mit jedem verarbeiteten Token steigen und von den Tarifen des Anbieters abhängen. Über mehrere Jahre summiert sich diese OPEX-Belastung, ohne dass dem Unternehmen eigene Vermögenswerte verbleiben.
Im direkten Vergleich dazu steht der Aufbau einer eigenen On-Premises-Inferenzplattform im Rechenzentrum. Hier fallen zunächst Investitionen für Beschleunigerhardware, Netzwerkanbindung und Integration an; die Dimensionierung richtet sich nach Volumen, Modellgröße und Redundanzanforderungen.
Hinzu kommen laufende Kosten für Strom, Kühlung, Rechenzentrumsfläche, Wartungsverträge und qualifiziertes Betriebspersonal. Ob und wann sich der Eigenbetrieb rechnet, hängt vor allem von Auslastung und Stabilität des Volumens ab: Bei hohem, gleichmäßigem Bedarf verschiebt sich die Rechnung zugunsten eigener Hardware, bei schwankender oder geringer Nutzung bleibt der API-Bezug oft günstiger. Wie solche Modelle betrieblich skaliert werden, beleuchtet der Praxisbeitrag zu KI im Unternehmen.
Die Make-or-Buy Sourcing-Weiche und regulatorische Resilienz unter EU AI Act und BSI
Die Entscheidung über Bereitstellungsmodelle folgt nicht allein ökonomischen Kriterien, sondern muss zwingend regulatorische Leitplanken und die interne Reife der Betriebsteams berücksichtigen. In der betrieblichen Praxis hat sich eine Differenzierung nach drei wesentlichen Betriebspfaden bewährt.
Erstens (Eigenbetrieb): Unternehmen mit strengen Vertraulichkeitsanforderungen betreiben quelloffene Modelle vollständig im eigenen Perimeter auf dedizierten Inferenz-Nodes. Das stärkt die Datensouveränität und vermeidet Latenzen externer Cloud-Verbindungen.
Zweitens (Co-Managed): Organisationen mit begrenzten Spezialistenteams kombinieren eigene Rechenzentrumskapazitäten mit zertifizierten Managed-Service-Partnern. Der Dienstleister überwacht Laufzeiten und Sicherheitsupdates, während vertrauliche Unternehmensdaten im eigenen Rechenzentrum verbleiben.
Drittens (Managed Service): Standardisierte und unkritische Front-End-Workloads greifen über verschlüsselte Gateways auf mandantenfähige Enterprise-APIs zu. Klare Serviceverträge und vertragliche Datenausschlussklauseln sichern den operativen Betrieb gegen unzulässiges Modelltraining ab.
Flankiert werden diese Modelle von den verschärften Vorgaben der europäischen Gesetzgebung. Die Verordnung (EU) 2024/1689 (EU AI Act) fordert für Hochrisiko-Systeme unter anderem ein Risikomanagement, Vorgaben zur Daten-Governance, die automatische Protokollierung von Ereignissen sowie angemessene Cybersicherheit. Unabhängig von der Risikoklasse sollten bei Systemen der Stufen drei und vier Schutzmaßnahmen gegen Prompt-Injection und unberechtigte Tool-Ausführung geprüft und dokumentiert werden.
Ergänzend definieren die Leitfäden des Bundesamts für Sicherheit in der Informationstechnik (BSI) klare Standards zur Härtung von Inferenzservern und zur Isolation von Trainingsumgebungen. Wer von Beginn an auf auditierbare, offene Standards setzt, reduziert Auditkosten und begegnet künftigen Prüfungen von Aufsichtsbehörden mit nachweisbarer Gelassenheit.
Der 4-Phasen-Umsetzungsfahrplan: Von der Evaluierung zur produktiven Inferenz-Fabrik
Die schrittweise Einführung einer mehrstufigen KI-Architektur im laufenden Unternehmensbetrieb erfordert ein strukturiertes Vorgehen. Ein Zeithorizont von sechs bis zwölf Monaten stellt sicher, dass Governance, Betriebsprozesse und Fachbereichsanforderungen harmonisch zusammenwachsen.
Phase 1 (Monat 1 bis 2): Workload-Klassifizierung und Daten-Governance
Im ersten Schritt analysiert das Projektteam sämtliche geplanten Anwendungsfälle der Fachbereiche. Jeder Anwendungsfall wird anhand von Latenzanforderungen, Datenkritikalität und Komplexität einer der vier Architekturstufen zugeordnet. Gleichzeitig werden Klassifizierungsvorgaben für vertrauliche Dokumente definiert und Berechtigungsgrenzen für nachfolgende Modellzugriffe im Active Directory oder IAM-System hinterlegt.
Phase 2 (Monat 3 bis 4): Architektur-Proof-of-Concept und Latenz-Benchmarking
In einer isolierten Testumgebung wird das Zusammenspiel von Inferenz-Engines wie vLLM oder TensorRT-LLM mit ausgewählten Modellen evaluiert. Das Infrastrukturteam misst Durchsatz, Time-to-First-Token und KV-Cache-Verhalten unter realistischer Last. Parallel wird ein intelligentes Routing-Gateway implementiert, das deterministische Anfragen direkt abfängt und nur anspruchsvolle Tasks an probabilistische Stufen übergibt.
Phase 3 (Monat 5 bis 6): Multi-Agenten-Orchestrierung und Pilot-Rollout
Auf Basis stabiler Einzelmodelle werden erste kollaborative Agentenketten für ausgewählte Fachbereiche aufgesetzt. Die Agenten erhalten definierte Schnittstellen zu ERP- und CRM-Systemen unter Verwendung temporärer Dienstkonten und strikter Least-Privilege-Rechte. Erste Pilotnutzer validieren die Ergebnisqualität und dokumentieren Fehlerfälle im zentralen Logging-System.
Phase 4 (Monat 7 bis 12): Autonome Inferenz-Skalierung und SLA-Monitoring
Nach erfolgreicher Pilotierung wird die Inferenz-Plattform in den regulären Produktivbetrieb überführt. Ein automatisiertes Monitoring überwacht GPU-Auslastung, Speicherüberläufe und Antwortlatenzen rund um die Uhr. Regelmäßige Evaluationsläufe vergleichen die Qualität der Antworten mit definierten Benchmarks, um Drift und Leistungseinbußen frühzeitig vor dem Auftreten von Störungen zu korrigieren.
Fünf Kontrollfragen für Vorstand und IT-Leitung zu KI-Architekturstufen
1. In welche Architekturstufe fallen unsere geplanten Anwendungsfälle?
Lassen Sie für jedes Vorhaben eine präzise Zuordnung nach Komplexität und Speicherbedarf erstellen. Nur wenn eindeutig feststeht, ob eine Heuristik, ein statistisches Basismodell oder ein Reasoning-System benötigt wird, lässt sich die Dimensionierung der Beschleunigerhardware betriebswirtschaftlich und technisch fundiert begründen.
2. Wie entwickeln sich unsere Token- und Inferenzkosten über 36 und 60 Monate?
Verlangen Sie vom Finanzcontrolling eine dynamische Modellierung bei steigenden Nutzerzahlen. Externe Hyperscaler-APIs erscheinen bei geringem Startvolumen attraktiv, können sich bei flächendeckender Nutzung jedoch zu einem schwer kalkulierbaren Kostenblock gegenüber dedizierten Inferenz-Servern im eigenen Rechenzentrum entwickeln.
3. Welche Latenz- und Speicherengpässe begrenzen unsere Inferenz-Pipelines?
Untersuchen Sie das Verhalten Ihrer Systeme bei Spitzenlasten und langen Eingabekontexten. Da der KV-Cache wertvollen HBM-Speicher blockiert, müssen Inferenz-Frameworks moderne Paged-Attention-Verfahren unterstützen, um teure Serverstillstände oder Antwortverzögerungen im operativen Betrieb zu verhindern.
4. Wie stellen wir die Governance und Nachvollziehbarkeit autonomer Agenten sicher?
Klären Sie verbindlich, welche Systeme autorisiert sind, eigenständig Aktionen in Kernsystemen wie SAP oder Salesforce auszuführen. Für jede autonome Interaktion müssen lückenlose Audit-Logs und manuelle Freigabeprozesse für geschäftskritische Transaktionen fest verankert sein.
5. Welche regulatorischen Pflichten entstehen aus dem EU AI Act für unsere Systeme?
Prüfen Sie vor dem Produktivgang, ob eingesetzte Modelle unter Hochrisiko-Kategorien des europäischen Regelwerks fallen. Eine sorgfältige Dokumentation der Datenquellen, Fehlertoleranzen und menschlichen Aufsichtsmechanismen schützt Ihr Unternehmen vor empfindlichen Bußgeldern und Reputationsverlusten.
Vom Hype-Getriebenen Pilotprojekt zur resilienten KI-Architektur
Die Euphorie um künstliche Intelligenz weicht in europäischen Chefetagen zunehmend einer nüchternen ingenieurtechnischen Betrachtung. IT-Verantwortliche erkennen, dass der Mehrwert nicht im blinden Konsum externer Cloud-Dienste liegt, sondern im präzisen architektonischen Zusammenspiel spezialisierter Komponenten.
Wer seine betrieblichen Prozesse konsequent nach den vier Architekturstufen strukturiert, schafft eine skalierbare und wirtschaftliche Plattform. Die Kombination aus bewährten deterministischen Filtern, performanten lokalen Basismodellen und zielgerichtetem Sovereign Reasoning schafft Spielraum für künftige Anforderungen, stärkt die Datenhoheit und macht Kosten planbarer.
Häufig gestellte Fragen (FAQ) zu den 4 Arten von KI
Worin unterscheidet sich Stufe 2 von echtem Sovereign Reasoning in Stufe 4?
Systeme der Stufe zwei generieren Antworten rein probabilistisch auf Basis vortrainierter Gewichtungen ohne interne Verifikationsphase. Stufe-vier-Modelle nutzen hingegen Test-Time Compute, um mehrere logische Lösungsbäume vor der Ausgabe systematisch zu durchdenken, Zwischenergebnisse zu überprüfen und Fehler eigenständig zu korrigieren.
Warum sind reaktive Systeme der Stufe 1 in modernen Architekturen weiterhin unverzichtbar?
Deterministische Regelsysteme liefern garantierte Antworten im Mikrosekundenbereich bei minimalem Ressourcenverbrauch. Sie eliminieren Halluzinationen vollständig und eignen sich ideal als vorgeschaltete Filter für Compliance-Prüfungen, Validierungen und das Vorab-Routing vor teuren probabilistischen Modellen.
Welche technischen Flaschenhälse treten beim Betrieb von Stufe-2-Modellen auf?
Der primäre Flaschenhals ist die Speicherbandbreite und Kapazität des High-Bandwidth-Memory (HBM). Bei langen Dokumenten wächst der Key-Value-Cache rasant an, was die parallele Bearbeitung von Nutzeranfragen begrenzt und spezialisierte Optimierungen wie Quantisierung oder Paged Attention erfordert.
Wie lässt sich die Ausführung autonomer Multi-Agenten der Stufe 3 absichern?
Sicherheitsarchitekten etablieren strikte Least-Privilege-Zugriffsrechte, Sandbox-Umgebungen und systemische Timeouts. Kritische Aktionen wie Datenbankänderungen oder Finanztransaktionen erfordern zwingend eine explizite Bestätigung durch menschliche Administratoren über Human-in-the-Loop-Schnittstellen.
Ab welchem monatlichen Anfragevolumen lohnt sich der Aufbau eigener Inferenz-Hardware?
Eine pauschale Schwelle gibt es nicht. Entscheidend sind Höhe und Stetigkeit des Volumens, die benötigte Modellgröße, Auslastung der Hardware sowie Personal- und Betriebskosten. Bei hohem, gleichmäßigem Bedarf rechnet sich eigene Hardware eher; hinzu kommt die volle Kontrolle über die Verarbeitung vertraulicher Daten.
Auditierbare Primärquellen & Technische Referenzen
| Institution & Herausgeber | Primärquelle & Normdokument | Architektonische Relevanz für den CIO |
|---|---|---|
| Europäische Union (Amtsblatt EUR-Lex) | Verordnung (EU) 2024/1689 (EU AI Act) ↗ | Verbindliche Risikoklassifizierung für KI-Systeme, Transparenzpflichten bei generativen Modellen und Governance-Vorgaben für den Produktiveinsatz. |
| National Institute of Standards and Technology (NIST) | NIST AI Risk Management Framework (AI RMF 1.0) ↗ | Standard zur Risikobewertung, Vertrauenswürdigkeit, Validierung und kontinuierlichen Überwachung autonomer und generativer KI-Infrastrukturen. |
| Institute of Electrical and Electronics Engineers (IEEE) | IEEE Standards Association Autonomous & AI Systems ↗ | Technische Referenzstandards zur Systemarchitektur, Datenintegrität und Schnittstellenspezifikation für kollaborative Multi-Agenten-Systeme. |
| Bundesamt für Sicherheit in der Informationstechnik (BSI) | BSI: Generative KI-Modelle – Chancen und Risiken für Industrie und Behörden, Januar 2025 ↗ | Risiken und Gegenmaßnahmen beim Einsatz generativer Modelle, darunter Prompt-Injection, Datenabfluss und Absicherung des Betriebs; ergänzt den isolierten On-Premises-Betrieb von Inferenz-Servern, Modellschutz und mandantenfähige Zugriffskontrollen. |
| Organisation for Economic Co-operation and Development (OECD) | OECD Recommendation on Artificial Intelligence (OECD AI) ↗ | Internationale Referenzprinzipien für verlässliche, transparente und rechenschaftspflichtige KI-Systeme in Unternehmensarchitekturen. |
| World Economic Forum (Sekundärveröffentlichung) | Arend Hintze / World Economic Forum: The four types of AI: what you need to know, November 2016 ↗ | Ursprung der verbreiteten Einteilung in reaktive Maschinen, begrenztes Gedächtnis, Theory of Mind und Selbstbewusstsein; Typen drei und vier sind hypothetisch. |
*Modellrechnung: Alle angegebenen Lizenz-, Infrastruktur- und TCO-Werte verstehen sich als unverbindliche Beispielkalkulation auf Basis typischer Szenarien.
**Verweise auf Gesetzestexte, Paragrafen (u. a. DSGVO, NIS-2, EU AI Act, DORA, GoBD, BetrVG) und Compliance-Normen dienen ausschließlich der unverbindlichen technischen Fachinformation für IT-Entscheider. Sie stellen keine Rechtsberatung nach dem Rechtsdienstleistungsgesetz (RDG) dar; für eine rechtsverbindliche Beurteilung Ihrer spezifischen Unternehmensorganisation konsultieren Sie bitte Ihren Rechtsbeistand oder Datenschutzbeauftragten.

DAS CxO-PARADOX
Wie falsche digitale Souveränität Wirtschaft und Staat entkernt und wie echte Unabhängigkeit gelingt.
Von Mathias Diwo · Executive Tech Advisor
- ✓ 6-Hebel-Plan: Geordneter Ausstieg aus VMware- & Hyperscaler-Lock-ins
- ✓ Board Scorecard: One-Page IT-Governance für Vorstand & Aufsichtsrat
- ✓ Sofort lesbar: Vollständiges Kapitel 1 als Vorab-Dossier
Strategische Vertiefung im gleichen Themencluster
Weiterführende Architektur- und Handlungsleitfäden für CIOs & IT-Entscheider.
Sieben KI-Fabriken für Europa: Wer wird dort Kunde?
Am 12. November endet die EU-Ausschreibung für bis zu sieben KI-Gigafabriken. Für Unternehmen im DACH-Raum zählt weniger die Rechenleistung als die Frage, ob daraus ein kaufbares Angebot wird. Eine Einordnung.
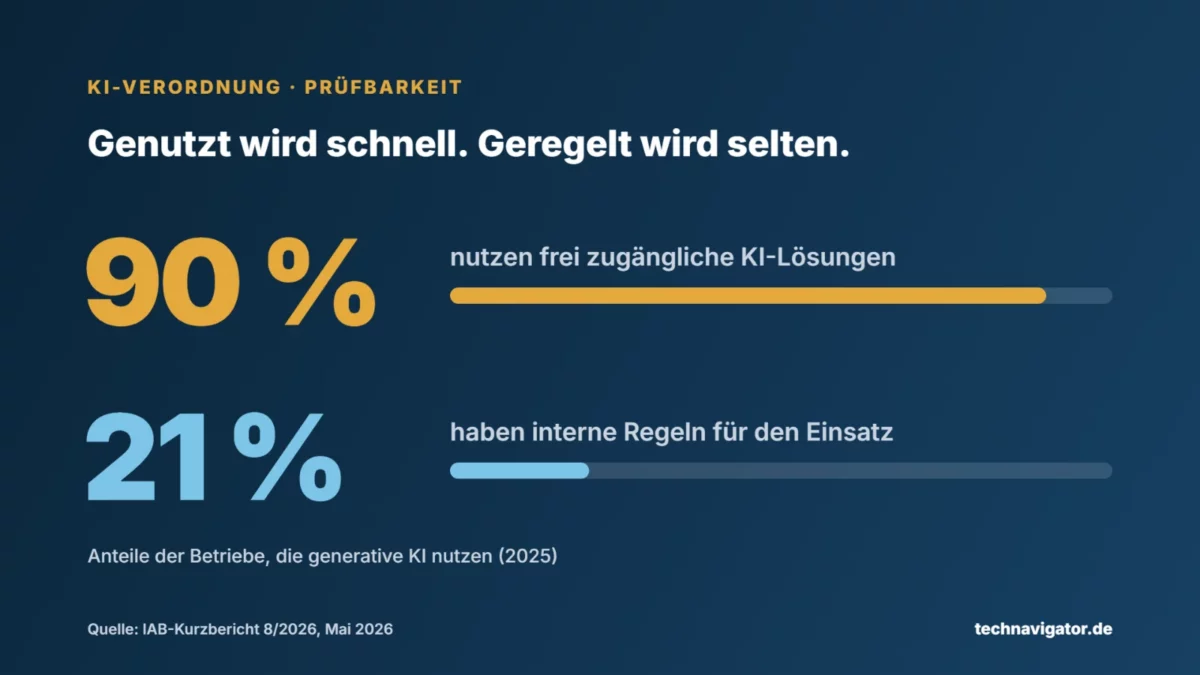
KI-Verordnung im Unternehmensalltag: Wie KI-Einsatz bis 2028 prüfbar wird
Verbote, Pflichten zur KI-Kompetenz und Transparenzregeln der KI-Verordnung gelten bereits, die Hochrisiko-Pflichten folgen nach dem Omnibus-Paket ab Dezember 2027. Wer bis dahin kein KI-Inventar führt, Rollen nicht klärt und Einkauf wie Dokumentation nicht darauf ausrichtet, wird Fragen von Aufsicht, Prüfern und Kunden nicht beantworten können.
Mathias Diwo
Herausgeber & Executive Tech AdvisorGründer von TechNavigator.de, Buchautor (HYBRID WORK) und strategischer Beirat für CIOs und Vorstände. Begleitet mittelständische Konzerne und Verwaltungsorganisationen bei Cloud-Exit-Strategien, NIS-2 Haftungsschutz und digitaler Souveränität.