Funktionsweise von Cloud Computing: Hypervisor, SDN und Orchestrierung im Detail
Das Wichtigste in Kürze
- ✓Hardware-Abstraktion auf Bare Metal: Typ-1-Hypervisoren wie KVM (etwa im AWS Nitro System) und darauf aufsetzende MicroVM-Monitore wie Firecracker nutzen Intel VT-x, AMD-V sowie SR-IOV- und SmartNIC-DPU-Offloading für eine Ausführung mit geringem Overhead.
- ✓Software-Defined Networking (SDN): Mandantenfähige Overlay-Netze via EVPN-VXLAN, BGP-Routing und eBPF/Cilium-Paketverarbeitung direkt im Linux-Kernel ersetzen starre Hardware-VLANs.
- ✓Verteilter Block- und Objektspeicher: Ceph RADOS verteilt Daten deterministisch über den CRUSH-Algorithmus mittels 3x-Replikation oder Erasure Coding ohne zentrale Lookup-Tabellen.
- ✓Deklarative Control Planes & TCO*-Vorteil: Kontinuierliche Reconciliation-Loops in Kubernetes und OpenStack sichern Self-Healing und können die 5-Jahres-TCO gegenüber Silo-IT spürbar senken.
Für Endanwender und viele kaufmännische Entscheider erscheint Cloud Computing oft wie ein abstraktes Versprechen der Digitalwirtschaft. Rechenkapazitäten stehen scheinbar grenzenlos auf Abruf bereit, neue Serverinstanzen starten per API-Aufruf innerhalb weniger Sekunden und Speicherpools dehnen sich elastisch im laufenden Betrieb aus.
Hinter dieser komfortablen Self-Service-Fassade verbirgt sich jedoch kein immaterieller Zauber, sondern ein streng deterministisches Zusammenspiel moderner Systemarchitektur. Hardwaregestützte Prozessor-Virtualisierung, programmierbare Kernel-Netzwerkpfade, mathematische Speicherverteilung und deklarative Steuerungs-Engines greifen auf Bare-Metal-Servern präzise ineinander.
Wer Cloud-Infrastrukturen als CIO oder Chefarchitekt strategisch bewerten, gegen Ausfälle härten und wirtschaftlich betreiben will, darf sich nicht mit Marketing-Metaphern begnügen. Eine fundierte Architektur-Governance erfordert das genaue Verständnis der technischen Wirkungsmechanismen vom physischen Silizium über den Betriebssystem-Kernel bis zur orchestrierten Programmierschnittstelle.
Vom statischen Blech-Silo zur programmierbaren Ressourcen-Fabric
Vor der Etablierung softwaredefinierter Cloud-Architekturen operierten Unternehmensrechenzentren nach dem Prinzip des dedizierten Silo-Hostings. Jede geschäftskritische Applikation, vom ERP-Kern über relationale Datenbanken bis zum Mailserver, erhielt eigene physische Server zugewiesen, die starr mit proprietären Storage-Area-Networks (SAN) und manuell konfigurierten Switches verkabelt waren.
Dieses Betriebsmodell litt unter struktureller Ressourcenverschwendung. Da jedes Blech-System für die theoretische Jahreshöchstlast ausgelegt werden musste, lag die durchschnittliche CPU-Auslastung typischer x86-Server im Jahresmittel oft niedrig, während Strom- und Kühlkapazitäten permanent für ungenutzte Leerlaufzyklen bezahlt wurden.
Gleichzeitig bremste die physische Bereitstellung Innovationen spürbar. Benötigte eine Fachabteilung neue Test- oder Produktionsumgebungen, erstreckten sich Hardware-Ausschreibung, Lieferung, Rack-Einbau, SAN-Zoning und Firewall-Freischaltung über mehrere Wochen oder Monate, was agile Release-Zyklen technisch unmöglich machte.
Architektonischer Blindspot: Wenn Cloud-Abstraktion das Verständnis für physische Systemgrenzen verdrängt
Weil Public-Cloud-Konsolen sämtliche Hardware-Details hinter simplen Schiebereglern verbergen, verlieren viele Entwicklerteams das Bewusstsein für reale Systemgrenzen wie CPU-Cache-Lokalität, NUMA-Topologien, PCIe-Lanes und Netzwerk-MTU-Größen. Treten unter Last plötzlich Tail-Latenzen durch Cross-Socket-Speicherzugriffe oder Paketfragmentierung im Overlay-Netz auf, werden kostspielige Instanz-Upgrades gebucht, statt die zugrundeliegende Virtualisierungs- und Kernel-Konfiguration sauber zu optimieren.
Hinzu kommt die Ressourcenteilung: Je nach Instanztyp teilen sich Mandanten physische Kerne, Caches und Speicherpfade. Bei burstfähigen oder überbuchten Instanzklassen können Lastspitzen benachbarter Mandanten CPU-Steal-Zeiten und schwankende I/O-Latenzen verursachen (Noisy-Neighbor-Effekt). Dedizierte Hosts, Bare-Metal-Instanzen oder CPU-Pinning grenzen dieses Risiko ein, kosten aber einen Teil der Elastizität.
Erst die Entkopplung der logischen Ausführungs-, Speicher- und Netzwerkebenen von der darunterliegenden COTS-Hardware (Commercial Off-The-Shelf) löste diese Starre auf. Durch die Bündelung standardisierter Serverknoten in dynamisch teilbare Ressourcenpools steigt die reale Hardwareauslastung deutlich bei gleichzeitiger Bereitstellung im Sekundentakt.
Ergänzende Architektur-Analysen und technische Entscheidungsmatrizen für die IT-Planung finden sich in den weiterführenden Beiträgen zu Cloud-Dienste im Enterprise-Einsatz sowie zu Cloud-Merkmale im Enterprise-Einsatz.
Schicht 1 (Compute): Typ-1-Hypervisoren, MicroVMs und DPU-Offloading
Das technische Fundament jeder Cloud-Umgebung bildet die Abstraktion von Prozessor, Hauptspeicher und I/O-Bussen durch einen Typ-1-Hypervisor (Bare-Metal-Hypervisor). Im Gegensatz zu Typ-2-Lösungen, die als gewöhnliche Anwendung auf einem Desktop-Wirtssystem laufen, operiert ein Typ-1-Hypervisor unmittelbar auf der Hardware-Ebene. KVM (Kernel-based Virtual Machine) ist ein Modul des Linux-Kernels, der damit selbst zum Hypervisor wird, und wird deshalb in der Regel als Typ 1 eingeordnet.
Moderne Serverprozessoren stellen dafür spezielle Befehlssatzerweiterungen bereit, namentlich Intel VT-x und AMD-V. Diese unterteilen die CPU-Privilegien in einen hochprivilegierten VMX-Root-Modus für den Hypervisor und einen Non-Root-Modus für die Gast-Betriebssysteme, sodass unkritische Maschinenbefehle direkt ohne Software-Emulation auf den physischen Rechenkernen ausgeführt werden.
Speichervirtualisierung via EPT/RVI, NUMA-Pinning und KSM
Damit sich mehrere virtuelle Maschinen (VMs) denselben physischen Arbeitsspeicher teilen können, ohne fremde Datenbereiche auszulesen, greift eine zweistufige Adressübersetzung in der Memory Management Unit (MMU). Technologien wie Intel Extended Page Tables (EPT) und AMD Rapid Virtualization Indexing (RVI) übersetzen virtuelle Gast-Adressen direkt in der Hardware in physische Host-Speicheradressen.
Für latenzkritische Datenbanken und Telekommunikations-Workloads kombinieren Cloud-Architekten diese Mechanismen mit striktem NUMA-Pinning (Non-Uniform Memory Access) und HugePages. Dadurch greifen virtuelle Prozessorkerne (vCPUs) ausschließlich auf Speicherriegel zu, die direkt am selben physischen CPU-Sockel angebunden sind. Kernel Samepage Merging (KSM) kann zwar identische Speicherseiten zusammenführen, wird für latenzkritische und mandantengetrennte Workloads wegen Leistungs- und Seitenkanalrisiken aber meist deaktiviert.
Von QEMU/KVM zu AWS Nitro, Firecracker und SmartNIC-DPUs
Während klassische KVM-Implementierungen den Prozess QEMU nutzen, um virtuelle Hardware wie Netzwerkkarten, Storage-Controller und serielle Schnittstellen im User-Space des Host-Systems zu emulieren, gehen moderne Hyperscaler und Enterprise-Clouds noch einen Schritt weiter. Bei Architekturen wie etwa dem AWS Nitro System oder dedizierten SmartNICs (Data Processing Units, DPUs) wird die Geräte-Emulation für Netzwerk und Speicher weitgehend auf eigene Koprozessorkarten ausgelagert.
Ergänzend ermöglicht Single Root I/O Virtualization (SR-IOV) in Verbindung mit der Input-Output Memory Management Unit (IOMMU / Intel VT-d), dass sich eine physische 100-GbE-Netzwerkkarte oder ein NVMe-Laufwerk gegenüber dem PCIe-Bus als dutzende unabhängige Virtual Functions (VFs) präsentiert. Die Gast-VM kommuniziert per Direct Memory Access (DMA) ohne Hypervisor-Overhead direkt mit der Hardware und erreicht nahezu die Bare-Metal-Leistung.
Für hochdynamische Serverless-Funktionen und Container-Workloads kommen zudem leichtgewichtige MicroVMs wie Firecracker oder Cloud Hypervisor zum Einsatz. Sie reduzieren den Gerätemodell-Overhead auf ein absolutes Minimum aus VirtIO-Netzwerk und VirtIO-Blockgerät, starten laut Projektangabe in rund 125 Millisekunden und verbinden die hardwaregestützte Isolation einer VM mit eigenem Kernel mit der Kompaktheit von Linux-Containern (cgroups und Namespaces).
Schicht 2 (Networking): Software-Defined Networking mit EVPN-VXLAN und eBPF
Sobald tausende virtuelle Maschinen und Container innerhalb von Sekunden über wechselnde Serverknoten hinweg starten oder per Live-Migration verschoben werden, stoßen klassische Layer-2-Netzwerke an ihre Grenzen. Das traditionelle IEEE-802.1Q-VLAN-Protokoll unterstützt aufgrund seiner 12-Bit-VLAN-ID maximal 4.094 Segmente und erzwingt bei Topologieänderungen langsame Spanning-Tree-Neuberechnungen.
Moderne Cloud-Infrastrukturen trennen daher das physische Transportnetz (Underlay) konsequent vom logischen Mandantennetz (Overlay). Im Underlay kommt eine hochverfügbare Spine-Leaf-Architektur zum Einsatz, in der jeder Serverknoten redundant über Punkt-zu-Punkt-Layer-3-Verbindungen und das Border Gateway Protocol (BGP) angebunden ist, sodass sämtliche Leitungen aktiv über Equal-Cost Multi-Path (ECMP) genutzt werden.
Mandanten-Isolation über VXLAN-Tunnel und BGP-EVPN Control Plane
Auf diesem IP-Underlay spannt das Software-Defined Networking (SDN) virtuelle Layer-2- und Layer-3-Segmente über Kapselungsprotokolle wie VXLAN (IETF RFC 7348) oder Geneve (RFC 8926, etwa in Open Virtual Network, OVN) auf. Ein VXLAN Tunnel Endpoint (VTEP) im Hypervisor oder im Leaf-Switch verpackt die Ethernet-Frames der Gast-VM in UDP-Pakete und versieht sie mit einem 24-Bit VXLAN Network Identifier (VNI), der über 16 Millionen streng isolierte Mandantennetze erlaubt.
Damit die Serverknoten jederzeit wissen, hinter welchem physischen Host sich eine bestimmte virtuelle MAC- oder IP-Adresse befindet, dient BGP Ethernet VPN (EVPN nach RFC 7432, für VXLAN-Overlays ergänzt durch RFC 8365) als verteilte Control Plane. Statt unbekannten Datenverkehr per Broadcast durch das gesamte Rechenzentrum zu fluten, tauschen die VTEPs (Hypervisoren oder Leaf-Switches) Standortinformationen von Workloads deterministisch als BGP-Routen aus.
„Cloud Computing ist keine schwarze Magie fremder Großkonzerne, sondern angewandte Systeminformatik: Wer KVM-Virtualisierung, BGP-EVPN-Routing, eBPF-Datenpfade und Ceph-Storage architektonisch durchdringt, verwandelt Standard-Server in eine hochverfügbare, souveräne Infrastruktur.“
In modernen Cloud-Native-Umgebungen wird die Paketweiterleitung im Host-Kernel zusätzlich durch eBPF (Extended Berkeley Packet Filter) und Plattformen wie Cilium beschleunigt. Anstatt Netzwerkpakete durch tausende sequenzielle iptables- oder Netfilter-Regeln zu schleusen, klinken sich verifizierte eBPF-Bytecode-Programme direkt am Netzwerktreiber (XDP / Express Data Path) und auf Socket-Ebene ein, was Durchsatz und Mikrosegmentierung deutlich beschleunigt.
Schicht 3 (Storage): Verteilte Speicher-Fabrics mit Ceph RADOS und CRUSH
Die dritte Säule der Cloud-Funktionsweise betrifft die persistente Datenhaltung. Würde eine virtuelle Maschine ihre Festplattendaten lediglich auf der lokalen NVMe-SSD ihres aktuellen Host-Servers ablegen, wäre sie bei einem Hardwaredefekt dieses Knotens verloren. Gleichzeitig bilden monolithische Fibre-Channel-SAN-Schränke kostspielige Engpässe und potenzielle Single Points of Failure.
Software-Defined Storage (SDS) auf Basis von Ceph löst diesen Zielkonflikt durch eine vollständig verteilte, objektbasierte Speicherarchitektur namens RADOS (Reliable Autonomic Distributed Object Store). Jeder physische Speicherknoten betreibt für seine lokalen Enterprise-NVMe-Laufwerke eigene Object Storage Daemons (OSDs), die über die BlueStore-Engine direkt ohne zwischengeschaltetes Dateisystem auf die Rohblöcke zugreifen.
Deterministische Platzierung via CRUSH statt zentraler Metadaten-Tabellen
Der entscheidende architektonische Kunstgriff von Ceph liegt im Verzicht auf zentrale Verzeichnis- oder Lookup-Tabellen, die bei großen Datenmengen zwangsläufig zum Flaschenhals würden. Stattdessen verwenden sowohl Clients (etwa der KVM-Hypervisor über das librbd-Protokoll) als auch die Storage-Knoten den mathematischen CRUSH-Algorithmus (Controlled Replication Under Scalable Hashing).
Anhand einer kompakten Cluster-Topologiekarte (CRUSH-Map), welche die physischen Ausfalldomänen wie Server, Racks, Brandabschnitte und Rechenzentren abbildet, berechnet jeder Client pseudozufällig, aber vollkommen deterministisch, welcher primäre OSD für ein Datenobjekt zuständig ist. Auf demselben RADOS-Fundament stellt Ceph parallel Blockspeicher (RBD für VMs), POSIX-Dateisysteme (CephFS) und S3-kompatiblen Objektspeicher (RADOS Gateway) bereit.
3x-Replikation versus Erasure Coding und automatische Selbstheilung
Um den Ausfall einzelner NVMe-Medien oder ganzer Serverracks ohne Datenverlust zu überstehen, unterstützt ein solcher Speicherpool zwei komplementäre Schutzverfahren. Bei der 3x-Replikation wird jeder 4-Megabyte-Datenblock synchron über das dedizierte 25- oder 100-GbE-Storage-Netzwerk auf drei verschiedene Server in getrennten Racks geschrieben, bevor der Schreibvorgang gegenüber der Applikation bestätigt wird (Strong Consistency).
Für große S3-Objektspeicher, Backups und Datenarchive kommt hingegen Erasure Coding (beispielsweise im Schema k=4, m=2) zum Einsatz: Ein Datenblock wird in vier Datenfragmente zerlegt und um zwei mathematisch berechnete Paritätsfragmente nach dem Reed-Solomon-Verfahren ergänzt. Dadurch sinkt der Speicher-Overhead von 200 Prozent auf lediglich 50 Prozent bei unveränderter Ausfalltoleranz von zwei kompletten Knoten.
Fällt im laufenden Betrieb ein Speicherknoten aus, registrieren die im Paxos-Quorum arbeitenden Ceph-Monitore die Statusänderung binnen Sekunden. Nach einer konfigurierbaren Wartezeit (standardmäßig zehn Minuten) starten die verbleibenden OSD-Knoten ohne manuellen Eingriff des Administrators im Hintergrund das sogenannte Rebalancing (Recovery und Backfill) und stellen die definierte Redundanzstufe auf den gesunden Laufwerken vollautomatisch wieder her.
Dahinter steht eine grundsätzliche Abwägung, die das CAP-Theorem beschreibt: Tritt eine Netzpartition auf, kann ein verteiltes System nicht zugleich strikte Konsistenz und volle Verfügbarkeit garantieren. Ceph entscheidet sich für Konsistenz. Nur der Clusterteil, der die Mehrheit der Monitor-Knoten hält, bleibt schreibberechtigt; isolierte Knoten blockieren Schreibzugriffe. Das verhindert Split-Brain-Zustände, in denen zwei getrennte Clusterhälften denselben Datenbestand widersprüchlich überschreiben würden.
Schicht 4 (Control Plane): Deklarative Orchestrierung und Reconciliation Loops
Erst die vierte Architekturschicht verwandelt virtualisierte Server, SDN-Tunnel und verteilten Speicher in eine vollwertige Cloud: die Orchestrierungs- und Control-Plane-Ebene, repräsentiert durch Systeme wie OpenStack für Infrastructure-as-a-Service (IaaS) und Kubernetes für containerisierte Plattformdienste (PaaS/CaaS). Ihr zentrales Paradigma lautet deklarative Zustandssteuerung statt imperativer Einzelbefehle.
In einer klassischen IT-Umgebung führt ein Administrator nacheinander Befehle oder Skripte aus, um einen Server zu installieren; bricht ein Schritt ab, bleibt das System in einem undefinierten Zwischenzustand zurück. In einer Cloud-Control-Plane übergibt das Betriebsteam oder die GitOps-Pipeline hingegen ein deklaratives Manifest (im JSON- oder YAML-Format) an den zentralen API-Server, das ausschließlich den gewünschten Soll-Zustand beschreibt.
Dieser Soll-Zustand wird in einer hochverfügbaren, über den Raft-Konsensalgorithmus abgesicherten Schlüssel-Wert-Datenbank (wie etcd in Kubernetes) revisionssicher persistiert. Anschließend treten spezialisierte Controller-Prozesse in Aktion, die in einer endlosen Regelschleife (Reconciliation Loop) permanent den realen Ist-Zustand der Infrastruktur mit dem in etcd hinterlegten Soll-Zustand abgleichen.
Meldet ein Worker-Knoten keinen Heartbeat mehr, weil ein Netzteil defekt ist, markiert der Node-Controller ihn als nicht bereit; nach einer Toleranzzeit (standardmäßig fünf Minuten) werden die betroffenen Pods geräumt, und der ReplicaSet-Controller erkennt die Abweichung zwischen fünf geforderten und nur noch vier laufenden Instanzen. Der Scheduler bewertet daraufhin alle verbleibenden Hosts nach freien CPU- und RAM-Reserven, Anti-Affinitätsregeln sowie Storage-Zonen und weist das Kubelet eines gesunden Knotens an, die fehlende Instanz neu zu starten. In OpenStack übernimmt das für VMs ein zusätzlicher HA-Dienst wie Masakari.
Architektur-Matrix: Klassische Silo-IT versus moderne Cloud-Infrastruktur
Um die technischen Auswirkungen dieser vier Abstraktionsschichten für Architektur-Boards und Einkaufsverantwortliche strukturiert gegenüberzustellen, vergleicht die folgende Matrix die Funktionsweise traditioneller Rechenzentrums-Silos mit einem modernen, auf offenen Industriestandards basierenden Cloud-Stack:
| Architektur-Schicht | Klassische Rechenzentrums-IT (Silo) | Moderne Cloud-Architektur (Open Stack) | CIO-Bewertung |
|---|---|---|---|
| 1. Compute & Isolation | Statische Zuordnung pro Server oder monolithische Legacy-Hypervisoren ohne DPU-Offloading. | Typ-1-Hypervisor (KVM), Firecracker-MicroVMs und Linux-Container mit VT-x, EPT und SR-IOV. |
Nahezu native LeistungHohe Ressourcen-Auslastung
|
| 2. Netzwerk (SDN) | Manuell gepatchte Layer-2-Switches, starre VLANs (max. 4.094) und statische Hardware-Firewalls. | Spine-Leaf Layer-3-Fabric mit BGP-EVPN, VXLAN-Overlays (16 Mio. VNIs) und eBPF/Cilium im Kernel. |
Zero-Trust ReadyMandantentrennung in Echtzeit
|
| 3. Storage (SDS) | Proprietäre Fibre-Channel-SAN-Arrays mit teuren Controller-Upgrades und Hersteller-Lock-in. | Verteiltes Ceph RADOS auf Enterprise-NVMe-Servern mit CRUSH-Algorithmus und 3x-Replikation / EC. |
SelbstheilendLinear skalierbar ohne SAN
|
| 4. Control Plane | Manuelle Ticket-Prozesse, imperative Bash-Skripte und fehleranfällige Einzelkonfiguration. | Deklarative API-Steuerung (Kubernetes / OpenStack) mit etcd-Quorum und Reconciliation Loops. |
Autonomes FailoverBereitstellung in Sekunden
|
| 5. Portabilität & Recht | Hohe Bindung an proprietäre Appliance-Formate oder intransparente Hyperscaler-PaaS-Dienste. | Offene CNCF-, IETF- und Linux-Standards erleichtern die Workload-Mobilität, die der EU Data Act beim Anbieterwechsel unterstützt. |
Hohe SouveränitätBSI C5 & Data Act adressierbar
|
Diese Gegenüberstellung verdeutlicht, warum führende Branchen längst auf softwaredefinierte Cloud-Mechanismen angewiesen sind. In der Telekommunikation bilden KVM, SR-IOV und BGP-EVPN das Rückgrat moderner 5G-Kernnetze, in denen Network Functions Virtualization (NFV) Datenpakete mit geringer, planbarer Latenz auf Standard-Servern verarbeitet.
Ebenso profitieren regulierte Finanzdienstleister und Energieversorger von der deklarativen Selbstheilung. Weiterführende Referenzarchitekturen für den Aufbau unabhängiger Plattformen finden sich im Themendossier zur Souveränen IT-Infrastruktur und Cloud-Exit-Strategie sowie im Praxisleitfaden zur mandantenfähigen Community Cloud.
Vollkostenbetrachtung: Kostentreiber im TCO-Vergleich
Die technische Effizienz von Hypervisor-Konsolidierung, Software-Defined Storage und deklarativer Automatisierung schlägt sich unmittelbar in der Fünfjahres-Gesamtkostenrechnung (60 Monate TCO) nieder. Wie stark, hängt von Zahl und Auslastung der Anwendungssysteme, vom Speicherbedarf und von den Verfügbarkeitsanforderungen ab.
In einer gewachsenen Silo- und Legacy-Virtualisierungsumgebung erfordert ein solches Profil häufig viele schwach ausgelastete Server, zwei dedizierte Enterprise-SAN-Speichersysteme inklusive Fibre-Channel-Director-Switches sowie teure Core-basierte Software-Abonnements. Über die Laufzeit summieren sich Hardware-Abschreibungen (CAPEX), Herstellersupport, SAN-Wartungsverträge, Lizenzgebühren und ein hoher Strombedarf.
Würde dasselbe Unternehmen diese Dauerlast-Workloads unreflektiert im Lift-and-Shift-Verfahren als reservierte Instanzen inklusive Managed Block Storage (EBS) und NAT-Gateway-Traffic bei einem US-Hyperscaler mieten, entstünden dauerhaft hohe monatliche OPEX-Abflüsse ohne physischen Substanzwert; Speicher- und Datenverkehrsgebühren treiben die Kosten zusätzlich.
Setzt die Organisation stattdessen auf eine hochverdichtete, softwaredefinierte Cloud-Architektur auf Basis weniger, dicht bestückter Serverknoten mit KVM, Ceph-NVMe-Storage, eBPF-SDN und Kubernetes, sinkt der initiale Hardware-Invest inklusive redundanter Spine-Leaf-Switches. Hinzu kommen Enterprise-Support-Subscriptions, Colocation-Stellfläche, Strom und qualifiziertes Betriebspersonal. Ob die Gesamtkosten über die Laufzeit niedriger ausfallen, hängt vor allem von Auslastung, Teamgröße und Supportverträgen ab.
Make-or-Buy Sourcing-Weiche und regulatorische Anforderungen (BSI C5 & EU Data Act)
Da die Kerntechnologien des Cloud Computings als quelloffene Industriestandards unter dem Dach der Linux Foundation, der Cloud Native Computing Foundation (CNCF) und der IETF dokumentiert sind, sind Unternehmen nicht gezwungen, Cloud-Funktionalität ausschließlich bei außereuropäischen Großkonzernen einzukaufen. Für die Umsetzung haben sich drei klar abgegrenzte Betriebsmodelle etabliert.
Erstens (Eigenbetrieb): Organisationen mit einem qualifizierten Platform-Engineering-Team aus mehreren Spezialisten einschließlich Rufbereitschaft betreiben ihren eigenen Stack aus KVM/Proxmox oder OpenStack, Ceph und Kubernetes auf eigener Hardware in zertifizierten europäischen Colocation-Rechenzentren. Das stärkt die Datenhoheit, kann bei stabiler Grundlast die TCO senken und verringert die Abhängigkeit von fremden Lizenzmetriken.
Zweitens (Co-Managed): Unternehmen des gehobenen Mittelstands behalten die physische Hardware-Hoheit und die Anwendungssteuerung im eigenen Haus, vergeben jedoch die 24/7-Bereitschaft für den darunterliegenden Hypervisor-, Ceph- und SDN-Layer an einen spezialisierten europäischen Managed-Service-Partner. Sämtliche Infrastructure-as-Code-Playbooks (OpenTofu, Ansible) verbleiben dabei vertraglich im Git-Repository des Kunden.
Drittens (Managed Service): Teams ohne eigene Infrastruktur-Mannschaft nutzen souveräne europäische Public- oder Private-Cloud-Plattformen, die nachweislich auf offenen Standards wie dem Sovereign Cloud Stack (SCS, seit Oktober 2024 im Forum SCS-Standards der Open Source Business Alliance gepflegt) oder verwalteten CNCF-zertifizierten Kubernetes-Clustern basieren. So profitieren Entwickler von sofort einsatzbereiten Cloud-APIs, ohne in proprietäre Schnittstellen-Abhängigkeiten zu geraten.
Unabhängig vom gewählten Bereitstellungsmodell unterliegt die technische Funktionsweise strengen regulatorischen Prüfmaßstäben. Das Bundesamt für Sicherheit in der Informationstechnik (BSI) definiert im IT-Grundschutz-Baustein SYS.1.5 (Virtualisierung) sowie im Kriterienkatalog C5 (aktuell C5:2026, März 2026) Anforderungen zur kryptografischen und logischen Mandantentrennung, zur Härtung der Management-Schnittstellen gegen Hypervisor-Breakout-Angriffe (etwa mittels SELinux/sVirt und Seccomp) sowie zur physischen oder logischen Separierung von Administrations-, Produktions- und Speichernetzen.
Zusätzlich verpflichtet die Verordnung (EU) 2023/2854 (EU Data Act) seit 12. September 2025 in Kapitel VI (Art. 23 bis 31) die Anbieter von Datenverarbeitungsdiensten, Wechselhindernisse abzubauen, die Interoperabilität über offene Schnittstellen zu unterstützen und bei IaaS-Diensten die funktionale Äquivalenz am Zielsystem zu erleichtern. Der Übergang muss innerhalb von 30 Tagen erfolgen (bis zu sieben Monate bei technischer Unmöglichkeit), die Kündigungsfrist beträgt höchstens zwei Monate (Art. 25). Wechselentgelte sind bis 11. Januar 2027 höchstens kostendeckend und entfallen ab 12. Januar 2027 (Art. 29); reguläre Egress-Entgelte erfasst die Regel nicht. Interne Plattformbetreiber und Anwenderunternehmen trifft diese Pflicht nicht – für sie sind offene Schnittstellen vor allem die Voraussetzung, die Wechselrechte tatsächlich nutzen zu können.
Für Eigen- und Colocation-Betrieb in Deutschland setzt außerdem das Energieeffizienzgesetz (EnEfG) Grenzen: Rechenzentren, die ab dem 1. Juli 2026 den Betrieb aufnehmen, müssen nach § 11 EnEfG im Jahresdurchschnitt einen PUE-Wert von höchstens 1,2 und einen Mindestanteil wiederverwendeter Energie erreichen; für Bestandsanlagen gelten gestaffelte Zielwerte von 1,5 (ab Juli 2027) und 1,3 (ab Juli 2030). Ein Regierungsentwurf vom 24. Juni 2026 sieht Lockerungen vor (Bestand 1,6 bzw. 1,4, längere Fristen für Neubauten); das Gesetzgebungsverfahren war nach den ausgewerteten Quellen noch nicht abgeschlossen. Im Finanzsektor verlangt Art. 28 DORA zusätzlich ein Management der IKT-Drittparteienrisiken einschließlich erprobter Exit-Strategien; die NIS-2-Richtlinie, in Deutschland umgesetzt durch das NIS2UmsuCG (in Kraft seit 6. Dezember 2025), adressiert Lieferkettenrisiken für wesentliche und wichtige Einrichtungen.
Der 4-Phasen-Umsetzungsfahrplan: Aufbau einer souveränen Cloud-Architektur
Um die beschriebenen Funktionsprinzipien von Compute, SDN, Storage und Orchestrierung ohne operative Risiken im eigenen Unternehmen oder im Verbund mit einem europäischen Hosting-Partner einzuführen, hat sich ein phasenweises Vorgehen über sechs bis neun Monate bewährt.
Phase 1 (Monat 1 bis 2): Hardware-Standardisierung, Spine-Leaf-Design und Bare-Metal-Härtung
Zu Beginn definiert das Infrastruktur-Team ein einheitliches Server-Profil auf Basis von Enterprise-x86-Knoten mit aktivierten Virtualisierungserweiterungen (VT-x/AMD-V, IOMMU), TPM 2.0, Secure Boot und mindestens zwei redundanten 25- oder 100-GbE-Netzwerkkarten. Parallel wird das physische Spine-Leaf-Netzwerk als Layer-3-Fabric konzipiert, um Management-, VXLAN-Overlay- und Ceph-Storage-Verkehr sauber zu isolieren.
Phase 2 (Monat 3 bis 4): Inbetriebnahme des Ceph-Storage-Clusters und CRUSH-Map-Validierung
In der zweiten Phase erfolgt das Deployment des verteilten Speichersystems auf den dedizierten NVMe-Laufwerken. Die Architekten konfigurieren die CRUSH-Failure-Domains auf Rack- oder Brandabschnittsebene, richten separate Speicherpools mit 3x-Replikation für Datenbank-Blockgeräte und Erasure Coding für S3-Objektspeicher ein und validieren die IOPS- und Latenzwerte unter künstlich provozierten Knotenausfällen.
Phase 3 (Monat 5 bis 6): Rollout von KVM-Hypervisor, BGP-EVPN und eBPF-Netzwerkschicht
Anschließend werden die Compute-Knoten mit gehärteten Linux-Kernels und KVM in Betrieb genommen sowie über BGP-EVPN und VXLAN zu einer mandantenfähigen SDN-Fabric verbunden. Auf dieser Basis starten die ersten automatisiert bereitgestellten Kubernetes-Cluster mit Cilium als eBPF-Netzwerk-Plugin, inklusive durchgängiger Verschlüsselung des Ost-West-Datenverkehrs via WireGuard oder IPsec.
Phase 4 (Monat 7 bis 9): GitOps-Control-Plane, Observability und Workload-Onboarding
Im letzten Schritt wird die deklarative Steuerung über GitOps-Controller wie ArgoCD oder Flux sowie Infrastructure-as-Code-Pipelines (OpenTofu) produktiv geschaltet. Begleitet von einer zentralen Telemetrie-Plattform aus Prometheus, Grafana und OpenTelemetry migrieren die Fachteams ihre Applikationen schrittweise auf die neue Plattform und schalten die historischen Hardware-Silos ab.
Fünf Kontrollfragen für Vorstand und IT-Leitung zur Cloud-Architektur
1. Basiert unsere Cloud-Strategie auf offenen Standards oder proprietären Blackbox-Diensten?
Prüfen Sie kritisch, ob Ihre produktiven Workloads auf standardisierten Schnittstellen wie KVM, Kubernetes-APIs, S3-Objektspeicher und PostgreSQL aufsetzen oder tief mit herstellerspezifischen Hyperscaler-Diensten verdrahtet sind. Nur offene Protokolle auf den vier Kernschichten Compute, SDN, Storage und Orchestrierung sichern Ihre technische Handlungsfähigkeit im Sinne des EU Data Act.
2. Wie ist die logische Mandanten- und Netztrennung auf Hypervisor- und Kernel-Ebene abgesichert?
Verlangen Sie von Ihrem internen Plattformteam oder Cloud-Dienstleister einen konkreten Architektur-Nachweis gemäß BSI IT-Grundschutz SYS.1.5. Dazu gehört die Bestätigung, dass Management-Schnittstellen, VXLAN-Mandantentunnel und Ceph-Replikationsnetze strikt voneinander getrennt sind und Gast-VMs über sVirt/SELinux sowie aktuelle Microcode-Patches gegen Seitenkanalangriffe isoliert werden.
3. Übersteht unser Speicherkonzept den gleichzeitigen Ausfall eines kompletten Server-Racks ohne Datenverlust?
Lassen Sie sich die genaue Konfiguration der Ceph-CRUSH-Map bzw. der Storage-Redundanz vorlegen. Bei geschäftskritischen Datenbanken muss eine synchrone 3x-Replikation mit einer Mindest-Schreibquittierung (min_size=2) über drei physisch getrennte Ausfalldomänen hinweg aktiv sein, damit das Risiko von Split-Brain-Zuständen oder Datenverlust auch bei Wartungsarbeiten und gleichzeitigem Hardwaredefekt gering bleibt.
4. Wird die gesamte Cloud-Infrastruktur deklarativ als Code verwaltet und auf Wiederanlauf getestet?
Eine Cloud verdient ihren Namen nur, wenn manuelle Eingriffe auf Einzelsystemen durch deklarative Reconciliation-Loops ersetzt wurden. Stellen Sie sicher, dass sämtliche Netzwerk-, Speicher- und Cluster-Definitionen versioniert in einem Git-Repository liegen und der vollautomatische Wiederaufbau einer Umgebung im Rahmen von NIS-2-Notfallübungen regelmäßig verifiziert wird.
5. Kennen wir den exakten TCO-Wendepunkt zwischen Public-Cloud-Miete und eigener Cloud-Plattform?
Beauftragen Sie das IT-Controlling mit einer ehrlichen 60-Monats-Vollkostenrechnung, die neben den reinen Instanzpreisen auch die oft übersehenen Gebühren für IOPS-Spitzen, Snapshot-Speicher und Egress-Datenverkehr berücksichtigt. Ab welcher Grundlast sich eine eigene oder Co-Managed Open-Source-Cloud rechnet, hängt von Auslastung, Personalkosten und Supportverträgen ab.
Technologische Souveränität durch Architektur-Beherrschung
Wer die technische Funktionsweise des Cloud Computings auf den vier Ebenen Hypervisor-Virtualisierung, Software-Defined Networking, verteilter Datenspeicherung und deklarativer Orchestrierung durchdringt, versteht das Geschäftsmodell großer Public-Cloud-Anbieter. Elastizität, Hochverfügbarkeit und sekundenschnelle Bereitstellung sind keine exklusiven Eigenschaften amerikanischer Großrechenzentren, sondern das Resultat präzise abgestimmter Open-Source-Komponenten auf standardisierter Server-Hardware.
Für CIOs und IT-Architekten eröffnet dieses Verständnis den Weg aus der passiven Konsumentenrolle. Indem Unternehmen auf offene Industriestandards wie KVM, BGP-EVPN, eBPF, Ceph und Kubernetes setzen, verbinden sie die operative Agilität moderner Cloud-Plattformen mit kalkulierbaren Fünfjahreskosten und einem hohen Maß an digitaler Souveränität unter europäischem Rechtsrahmen.
Häufig gestellte Fragen (FAQ) zur Funktionsweise von Cloud Computing
Was unterscheidet einen Typ-1-Hypervisor technisch von Containern und MicroVMs?
Ein Typ-1-Hypervisor wie KVM nutzt Hardware-Erweiterungen der CPU (Intel VT-x, AMD-V), um vollständig isolierte virtuelle Maschinen mit jeweils eigenem Betriebssystem-Kernel auszuführen. Klassische Linux-Container teilen sich hingegen den Kernel des Host-Systems und isolieren Prozesse lediglich über Namespaces und cgroups. MicroVMs wie Firecracker kombinieren beide Welten, indem sie einen minimalen eigenen Kernel mit sehr schlanker Geräte-Emulation laut Projektangabe in rund 125 Millisekunden starten.
Warum setzen moderne Cloud-Netzwerke auf EVPN-VXLAN und eBPF statt auf klassische VLANs?
Klassische IEEE-802.1Q-VLANs sind auf 4.094 Netzwerksegmente begrenzt und skalieren in großen Rechenzentren wegen Spanning-Tree-Blockaden schlecht. VXLAN kapselt Layer-2-Frames in UDP-Pakete mit einem 24-Bit-Header für über 16 Millionen isolierte Mandantennetze, während BGP-EVPN die MAC- und IP-Routen dynamisch verteilt. Durch eBPF und Cilium werden Sicherheitsregeln und Routing zudem direkt im Linux-Kernel ohne langsamen iptables-Overhead durchgesetzt.
Wie verhindert Ceph Storage Datenverlust beim Ausfall eines kompletten Serverknotens?
Ceph verteilt sämtliche Datenblöcke über den mathematischen CRUSH-Algorithmus deterministisch auf verschiedene physische Server und Racks. Bei einer 3x-Replikation wird jeder Schreibvorgang erst bestätigt, wenn drei unabhängige NVMe-Laufwerke auf getrennten Knoten die Daten gespeichert haben. Fällt ein Server aus, bedienen die übrigen Knoten alle Anfragen unterbrechungsfrei weiter und stellen die fehlende Kopie auf den verbleibenden Laufwerken automatisch wieder her.
Wie funktioniert der deklarative Reconciliation-Loop in Kubernetes und OpenStack?
Anstatt einzelne Installationsbefehle manuell auszuführen, hinterlegen Administratoren ein YAML-Manifest mit dem gewünschten Zielzustand in der verteilten etcd-Datenbank der Control Plane. Spezialisierte Controller vergleichen diesen Soll-Zustand fortlaufend mit den real laufenden Instanzen. Weicht der Ist-Zustand durch einen Hardwareausfall oder Lastanstieg ab, triggert die Control Plane vollautomatisch den Neustart oder die Skalierung auf gesunden Knoten.
Welchen Performance-Verlust verursacht die Virtualisierungsschicht in einer modernen Cloud?
Dank hardwaregestützter Speicherübersetzung (EPT/RVI), NUMA-bewusstem CPU-Pinning, paravirtualisierten VirtIO-Treibern sowie SR-IOV und SmartNIC-DPU-Offloading ist der messbare Overhead moderner KVM-Clouds gering. Virtualisierte Cloud-Instanzen erreichen damit nahezu die native Bare-Metal-Geschwindigkeit.
Auditierbare Primärquellen & Technische Referenzen
| Institution & Herausgeber | Primärquelle & Normdokument | Architektonische Relevanz für den CIO |
|---|---|---|
| Internet Engineering Task Force (IETF) | IETF RFC 7348: Virtual eXtensible Local Area Network (VXLAN) ↗ | Technischer Basisstandard für mandantenfähige Layer-2-Overlay-Netzwerke über Layer-3-Spine-Leaf-Fabrics in Cloud-Rechenzentren. |
| Ceph Foundation (Linux Foundation) | Ceph Distributed Storage & CRUSH Architecture ↗ | Referenzdokumentation für den RADOS-Objektspeicher, BlueStore-NVMe-Backends, 3x-Replikation und Erasure Coding ohne zentrale Metadaten-Tabellen. |
| Cloud Native Computing Foundation (CNCF) | CNCF Cloud Native Architecture & Orchestration ↗ | Architekturvorgaben für deklarative Control Planes, Kubernetes-Reconciliation-Loops, etcd-Konsenshaltung und eBPF-Netzwerkintegration via Cilium. |
| Europäische Union (Amtsblatt EUR-Lex) | Verordnung (EU) 2023/2854 (EU Data Act Art. 23 bis 31) ↗ | Pflichten der Anbieter von Datenverarbeitungsdiensten zu Anbieterwechsel, Interoperabilität und offenen Schnittstellen; Wechselentgelte entfallen ab 12. Januar 2027 (Art. 29). |
| Bundesamt für Sicherheit in der Informationstechnik (BSI) | IT-Grundschutz-Baustein SYS.1.5 Virtualisierung ↗ | Anforderungen zur Härtung von Typ-1-Hypervisoren, strikter Netztrennung der Management-Ebene und Schutz vor Hypervisor-Breakout. |
| Bundesministerium der Justiz (gesetze-im-internet.de) | Energieeffizienzgesetz (EnEfG) § 11 ↗ | PUE-Zielwerte und Mindestanteil wiederverwendeter Energie für Rechenzentren in Deutschland. |
| Internet Engineering Task Force (IETF) | IETF: RFC 8926 – Geneve: Generic Network Virtualization Encapsulation, November 2020 ↗ | Erweiterbares Overlay-Kapselungsformat, das etwa Open Virtual Network (OVN) nutzt. |
| Kubernetes-Projekt (CNCF) | Kubernetes: Taints and Tolerations (Taint-based Evictions), Dokumentation, abgerufen November 2026 ↗ | Ablauf bei ausgefallenen Knoten: Taint durch den Node-Controller, Räumung der Pods nach Standard-Toleranz von 300 Sekunden. |
| Ceph-Projekt | Ceph: Configuring Monitor/OSD Interaction, Dokumentation, abgerufen November 2026 ↗ | Erkennung ausgefallener OSDs und Wartezeit, bevor Recovery und Backfill starten. |
| Firecracker-Projekt | Firecracker: Secure and fast microVMs for serverless computing, Projektseite, abgerufen November 2026 ↗ | Projektangaben (Herstellerangabe) zu Startzeit und minimalem Gerätemodell von MicroVMs. |
| Bundesamt für Sicherheit in der Informationstechnik (BSI) | BSI: Kriterienkatalog Cloud Computing C5:2026, März 2026 ↗ | Prüfkriterien für Cloud-Anbieter, unter anderem zu Mandantentrennung und Betrieb der Virtualisierungsschicht. |
| Sovereign Cloud Stack / OSBA | Sovereign Cloud Stack: OSBA gründet Forum SCS-Standards, Oktober 2024 ↗ | Weiterführung der SCS-Standards unter dem Dach der Open Source Business Alliance. |
| CMS Hasche Sigle (Sekundärquelle) | CMS: EnEfG-Novelle bringt Entlastung für Rechenzentren, Juli 2026 ↗ | Regierungsentwurf vom 24. Juni 2026 mit gelockerten PUE-Zielwerten für Bestandsrechenzentren und längeren Fristen für Neubauten. |
*Modellrechnung: Alle angegebenen Lizenz-, Infrastruktur- und TCO-Werte verstehen sich als unverbindliche Beispielkalkulation auf Basis typischer Szenarien.

DAS CxO-PARADOX
Wie falsche digitale Souveränität Wirtschaft und Staat entkernt und wie echte Unabhängigkeit gelingt.
Von Mathias Diwo · Executive Tech Advisor
- ✓ 6-Hebel-Plan: Geordneter Ausstieg aus VMware- & Hyperscaler-Lock-ins
- ✓ Board Scorecard: One-Page IT-Governance für Vorstand & Aufsichtsrat
- ✓ Sofort lesbar: Vollständiges Kapitel 1 als Vorab-Dossier
Strategische Vertiefung im gleichen Themencluster
Weiterführende Architektur- und Handlungsleitfäden für CIOs & IT-Entscheider.
Nach dem VMware-Schock: Wie sich Virtualisierungsstrategien dauerhaft verändern
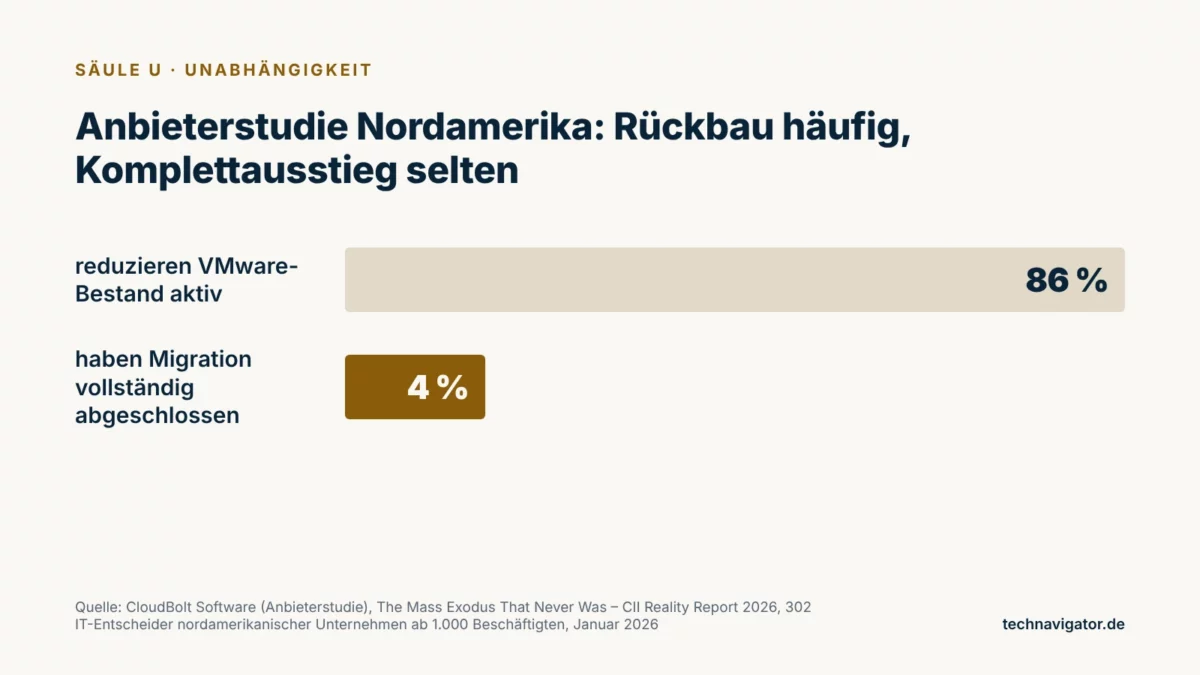
Drei Jahre nach der Übernahme durch Broadcom ist der befürchtete Massenauszug aus VMware ausgeblieben – die Abhängigkeit wird dennoch abgebaut, langsamer und gezielter als erwartet. Für die Geschäftsleitung wird Virtualisierung damit von einer Betriebsfrage zu einer Frage der Lieferantenstrategie.
VMware nach der Broadcom-Übernahme: Ausstieg und Proxmox-Migration für den CIO
Nach der Broadcom-Übernahme steigen die VMware-Lizenzkosten durch VCF-Core-Abonnements für viele Bestandskunden erheblich. Dieser Leitfaden analysiert die wirtschaftlichen Folgen und zeigt am Beispiel von Proxmox VE und Ceph einen strukturierten Migrationspfad zu KVM-basierten Plattformen.
Mathias Diwo
Herausgeber & Executive Tech AdvisorGründer von TechNavigator.de, Buchautor (HYBRID WORK) und strategischer Beirat für CIOs und Vorstände. Begleitet mittelständische Konzerne und Verwaltungsorganisationen bei Cloud-Exit-Strategien, NIS-2 Haftungsschutz und digitaler Souveränität.