
Das Ende des anonymen Inhalts: Wenn jedes Bild und jeder Text eine Herkunft trägt
Das Wichtigste in Kürze
- ✓Die Beweislast dreht sich: Heute muss das Gefälschte entlarvt werden. In den nächsten zwei Jahren wird sich zunehmend das Unmarkierte erklären müssen.
- ✓Vertrauen wandert vom Inhalt zum Absender: Nicht mehr das Bild überzeugt, sondern die prüfbare Kette dahinter: wer es erzeugt, bearbeitet und freigegeben hat.
- ✓Herkunft ist nicht Wahrheit: Ein Herkunftsnachweis belegt, woher ein Inhalt stammt – nicht, ob er stimmt. Redaktionelle Verantwortung wird dadurch wertvoller, nicht überflüssig.
- ✓Echtheit braucht Infrastruktur: Wer Zertifikate ausstellt und Vertrauenslisten führt, entscheidet mit, was als echt gilt. Das ist eine Souveränitätsfrage, die Europa noch nicht beantwortet hat.
Ein Etikett, das mehr verändert als es verspricht
Der Anlass ist unspektakulär. Artikel 50 der europäischen KI-Verordnung gilt seit dem 2. August 2026. Anbieter generativer Systeme müssen deren Ausgaben maschinenlesbar als künstlich erzeugt kennzeichnen; wer Deepfakes veröffentlicht, muss sie offenlegen. Der im Juni 2026 veröffentlichte Verhaltenskodex der Kommission konkretisiert das: Wo nötig, sollen mindestens zwei Ebenen der Markierung greifen, etwa Metadaten und Wasserzeichen. Für Systeme, die schon vor August im Markt waren, läuft die Übergangsfrist am 2. Dezember 2026 ab.
Gelesen als Pflichtenkatalog, ist das eine weitere Compliance-Aufgabe. Gelesen als Signal, ist es etwas anderes: Zum ersten Mal verlangt ein großer Wirtschaftsraum, dass digitale Inhalte eine maschinenprüfbare Auskunft über ihre Entstehung mit sich tragen. Was heute nur für KI-Ausgaben gilt, wird zum Muster für alle Inhalte. Denn sobald ein Teil der Bilder, Videos und Texte eine Herkunft ausweist, stellt sich für den Rest eine unbequeme Frage: Warum eigentlich nicht?
Die Ausgangslage: Vertrauen auf historischem Tiefstand
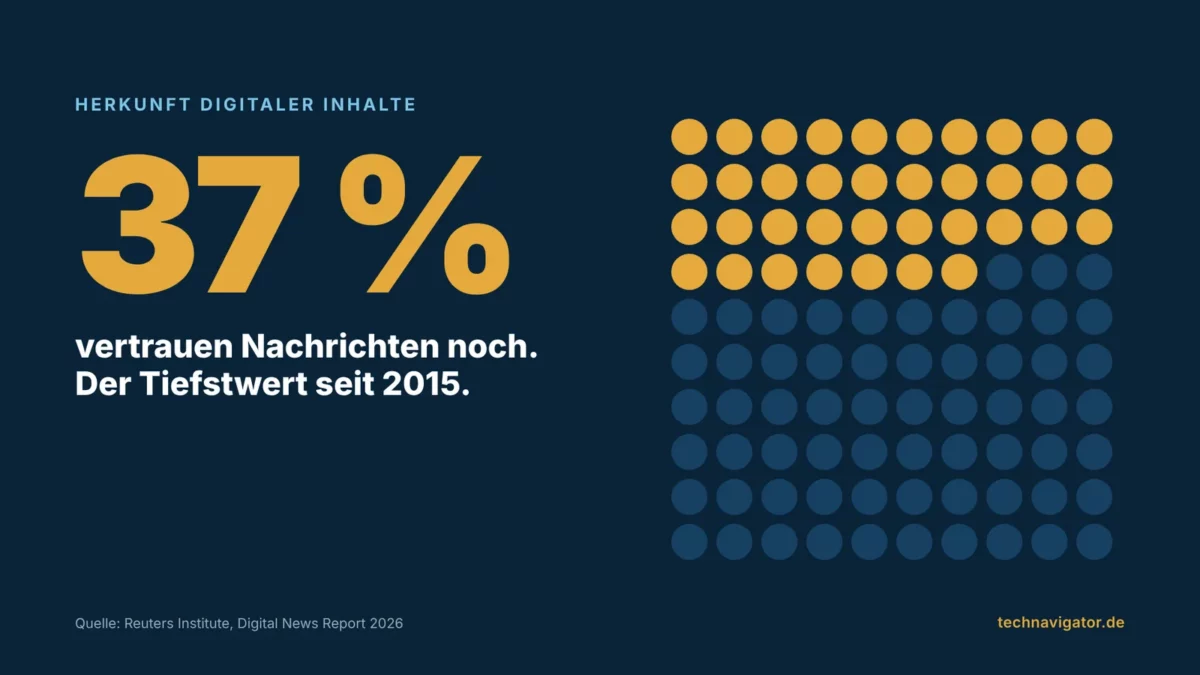
Die Kennzeichnung trifft auf eine Öffentlichkeit, deren Vertrauen bereits erodiert ist. Der Digital News Report 2026 des Reuters Institute misst das Vertrauen in Nachrichten weltweit bei 37 Prozent – dem niedrigsten Wert seit Beginn der Messung 2015. Gleichzeitig nutzt ein wachsender Teil des Publikums KI-Assistenten, um sich zu informieren. Die Menge synthetischer Inhalte steigt, die Fähigkeit des Einzelnen, Echtes von Erzeugtem zu unterscheiden, sinkt.
In dieser Lage hilft kein weiterer Appell an Medienkompetenz. Menschen können nicht jedes Bild forensisch prüfen. Gesellschaften lösen solche Probleme historisch mit Infrastruktur: mit Siegeln, Stempeln, Unterschriften, Registern. Herkunftsnachweise für digitale Inhalte sind der Versuch, diese Logik in die Welt der Dateien zu übertragen.
Was technisch bereits möglich ist
Der am weitesten verbreitete offene Standard dafür heißt C2PA, entwickelt von der Coalition for Content Provenance and Authenticity unter dem Dach der Linux Foundation. Er hängt an eine Datei ein kryptografisch signiertes Protokoll, die sogenannten Content Credentials: wer den Inhalt erzeugt hat, mit welchem Werkzeug, welche Bearbeitungsschritte folgten. Nach Angaben der Initiative arbeiten inzwischen mehr als 6.000 Mitglieder und angeschlossene Organisationen mit Anwendungen, die Content Credentials unterstützen. Die im Februar 2026 vorgestellte Version 2.3 erweitert den Standard auf Live-Übertragungen und erstmals auf reine Textdokumente.
Kamerahersteller signieren Fotos bereits beim Auslösen, erste Smartphones tun es ab Werk, große Plattformen lesen die Angaben aus. Das Bild, das daraus entsteht, ist jedoch noch lückenhaft – und gerade die Lücken sind für die Zukunft aufschlussreich.
Wo die Kette heute reißt
- Verlust bei der Weitergabe: Metadaten gehen verloren, wenn Plattformen Dateien beim Hochladen neu verarbeiten, komprimieren oder zuschneiden. Ein Nachweis, der den Empfänger nie erreicht, schafft kein Vertrauen.
- Herkunft ist nicht Inhalt: Ein Herkunftsnachweis belegt, wer eine Datei signiert hat. Ob die abgebildete Szene stimmt oder eine Aussage zutrifft, belegt er nicht.
- Unklare Vertrauensanker: Eine Signatur ist nur so viel wert wie das Zertifikat dahinter. Die Liste vertrauenswürdiger Aussteller befindet sich im Aufbau; zu Beginn 2026 waren nur zwei Zertifizierungsstellen als konform bestätigt, beide aus den USA.
Fünf Thesen für die nächsten zwei Jahre
These 1: Unmarkiert wird verdächtig
Heute ist ein Bild ohne Herkunftsangabe der Normalfall. Je mehr Kameras, Programme und Plattformen signieren, desto stärker verschiebt sich die Wahrnehmung. Das fehlende Signal wird selbst zum Signal. Datenschutzorganisationen warnen bereits davor, dass das Fehlen von Metadaten zu einem negativen Vertrauenssignal werden könnte. Für Unternehmen heißt das: Wer 2028 Inhalte ohne nachweisbare Herkunft veröffentlicht, wird sich zunehmend erklären müssen – auch wenn kein Gesetz es verlangt.
These 2: Vertrauen wandert vom Inhalt zum Absender
Bislang überzeugt ein Inhalt durch sich selbst: durch Qualität, Plausibilität, Aufmachung. Generative Systeme haben diese Merkmale beliebig herstellbar gemacht. Was knapp bleibt, ist ein überprüfbarer Absender. Marken, Behörden und Medienhäuser werden deshalb weniger an ihrer Gestaltung erkannt als an ihrer Signatur. Die digitale Unterschrift wird zum Kern der Markenführung – vergleichbar mit dem Briefkopf, der früher Echtheit verbürgte.
These 3: Redaktionelle Verantwortung wird zum Wertversprechen
Bemerkenswert ist eine Ausnahme im europäischen Regelwerk: KI-gestützte Texte zu Themen öffentlichen Interesses müssen nicht gekennzeichnet werden, wenn ein Mensch sie geprüft hat und eine benannte Person oder Organisation die redaktionelle Verantwortung trägt. Der Gesetzgeber setzt damit nicht auf Technik allein, sondern auf Haftung. In einer Welt unbegrenzter Inhalte wird genau das knapp und wertvoll: jemand, der mit seinem Namen für einen Text einsteht.
These 4: Echtheit wird zur Infrastrukturfrage
Wer entscheidet, welche Signatur als vertrauenswürdig gilt? Technisch sind es Vertrauenslisten und Zertifizierungsstellen. Politisch ist es eine Machtfrage. Wenn die Anker der digitalen Echtheit überwiegend außerhalb Europas betrieben werden, hängt die Glaubwürdigkeit europäischer Inhalte an Infrastruktur, die Europa nicht kontrolliert. Die Debatte über souveräne Cloud-Dienste wird sich in den nächsten Jahren auf die Frage ausweiten, wer die Echtheit von Information beglaubigt.
These 5: Fälschung im eigenen Namen wird zum Standardrisiko
Je glaubwürdiger signierte Inhalte werden, desto attraktiver wird es, sich fremder Identitäten zu bedienen: das gefälschte Video der Vorstandsvorsitzenden, die erfundene Pressemitteilung, die synthetische Stimme des Finanzchefs. Herkunftsnachweise verschieben dieses Risiko, sie beseitigen es nicht. Unternehmen brauchen deshalb nicht nur einen Weg, ihre eigenen Inhalte zu beglaubigen, sondern auch eine Antwort darauf, wie sie öffentlich belegen, was nicht von ihnen stammt.
Drei Szenarien bis 2028
Wie sich die Ordnung in den nächsten zwei Jahren tatsächlich entwickelt, ist offen. Drei Entwicklungslinien sind plausibel, und keine ist ohne Folgen für Entscheider.
- Offener Standard setzt sich durch: Kameras, Programme und Plattformen tragen Herkunftsangaben durchgängig weiter, mehrere unabhängige Vertrauensanker existieren nebeneinander, auch europäische. Herkunft wird auf dem Weg dorthin so selbstverständlich wie das Schloss-Symbol im Browser.
- Plattform-Siegel: Große Plattformen bauen eigene Echtheitssysteme, die nur innerhalb ihrer Angebote funktionieren. Vertrauen wird zur Dienstleistung einzelner Konzerne, Unternehmen müssen sich mehrfach beglaubigen lassen.
- Flickenteppich: Die Kennzeichnung bleibt auf KI-Inhalte und einzelne Branchen beschränkt, die Kette reißt an vielen Stellen. Das Vertrauen sinkt weiter, und wer kann, zieht sich in geschlossene Kanäle zurück.
Für Europa ist das erste Szenario das wünschenswerte. Es wird aber nicht von selbst eintreten. Es setzt voraus, dass Unternehmen, Medien und öffentliche Stellen offene Standards tatsächlich nutzen und dass europäische Vertrauensanker entstehen.
Herkunft digitaler Inhalte: heute und 2028
| Bereich | Heute | 2028 (absehbar) |
|---|---|---|
| Normalfall | Inhalte ohne Herkunftsangabe | Herkunftsangabe bei Medien, Marken und Behörden zunehmend erwartet, Fehlen erklärungsbedürftig |
| Vertrauen | Wirkung und Gestaltung des Inhalts | Prüfbarer Absender und Bearbeitungskette |
| KI-Inhalte | Markierung seit August 2026 Pflicht | Markierung eingespielte Praxis, Kontrolle durch Aufsicht und Plattformen |
| Redaktion | Kostenfaktor | Wertversprechen: benannte Verantwortung |
| Infrastruktur | Wenige Zertifizierungsstellen, im Aufbau | Offene Frage: europäische Vertrauensanker oder Abhängigkeit |
| Risiko | Deepfakes als Einzelfall | Identitätsmissbrauch als Standardrisiko der Kommunikation |
Was Entscheider heute klären sollten
Die Vorbereitung auf diese Ordnung ist weniger eine technische als eine strategische Aufgabe. Fünf Fragen gehören auf die Tagesordnung der Geschäftsleitung:
- Wer spricht für uns? Welche Personen und Stellen dürfen Inhalte im Namen des Unternehmens beglaubigen – und wie wird das nachweisbar?
- Was ist unser Bestand wert? Archive, Bilddatenbanken und Dokumentationen ohne Herkunftsangabe verlieren an Beweiskraft. Welche davon sind geschäftskritisch?
- Wo reißt unsere Kette? Zwischen Erstellung, Bearbeitung und Veröffentlichung durchlaufen Inhalte viele Werkzeuge. Wo gehen Herkunftsangaben heute verloren?
- Von wem hängt unsere Echtheit ab? Welche Zertifikate, Plattformen und Dienste müssten funktionieren, damit Dritte unsere Inhalte als echt erkennen – und was passiert, wenn einer davon wegfällt?
- Wie widerlegen wir eine Fälschung? Gibt es einen geübten Ablauf, um öffentlich und schnell zu belegen, dass ein Video, eine Stimme oder ein Dokument nicht von uns stammt?
Keine dieser Fragen verlangt eine Investitionsentscheidung in diesem Quartal. Alle verlangen, dass jemand im Unternehmen sie stellt, bevor der Markt die Antworten vorgibt.
Einordnung: Herkunft ist eine Form von Kontrolle
Die Kennzeichnung von KI-Inhalten wird oft als Verbraucherschutz verstanden. Sie ist mehr als das. Sie ist der Versuch, in einer Umgebung beliebig erzeugbarer Information wieder einen festen Punkt zu schaffen: die Verbindung zwischen einem Inhalt und jemandem, der dafür einsteht. Wer diese Verbindung beherrscht, gewinnt Vertrauen. Wer sie an Dritte abgibt, gibt einen Teil seiner Glaubwürdigkeit ab.
Darin liegt die eigentliche Botschaft für Entscheider. Die Frage ist nicht, ob Ihre Inhalte in zwei Jahren eine Herkunft tragen werden. Die Frage ist, ob Sie diese Herkunft selbst ausweisen können – oder ob andere darüber entscheiden.
Häufige Fragen
Betrifft die Kennzeichnungspflicht nur KI-Unternehmen?
Die Markierungspflicht trifft die Anbieter generativer Systeme. Wer KI-Werkzeuge nutzt und damit Deepfakes oder Texte zu öffentlichen Themen veröffentlicht, hat eigene Offenlegungspflichten. Strategisch relevant ist das Thema für jedes Unternehmen, das öffentlich kommuniziert, weil sich die Erwartung an nachweisbare Herkunft auf alle Inhalte ausweiten dürfte.
Was sind Content Credentials?
Content Credentials sind kryptografisch signierte Angaben, die an eine Datei angehängt werden und dokumentieren, wer sie erzeugt und wie sie bearbeitet wurde. Sie beruhen auf dem offenen Standard C2PA. Sie belegen die Herkunft eines Inhalts, nicht seine inhaltliche Richtigkeit.
Lässt sich eine Fälschung mit Herkunftsnachweisen sicher erkennen?
Nein. Ein Herkunftsnachweis zeigt, wer eine Datei signiert hat und ob sie seitdem verändert wurde. Fehlt der Nachweis, ist ein Inhalt nicht automatisch gefälscht, denn Metadaten gehen bei der Weitergabe häufig verloren. Herkunftsnachweise ergänzen redaktionelle Prüfung und Erkennungsverfahren, sie ersetzen sie nicht.
Warum ist das ein Thema digitaler Souveränität?
Weil die Glaubwürdigkeit einer Signatur von Zertifizierungsstellen und Vertrauenslisten abhängt. Wer diese Infrastruktur betreibt, bestimmt mit, welche Inhalte als echt erkannt werden. Bislang liegt sie überwiegend außerhalb Europas.
Quellen
- Europäische Kommission: Code of Practice on marking and labelling of AI-generated content (Entwürfe und Übersicht)
- Jones Day: European Commission publishes final Code of Practice on marking and labelling AI-generated content, Juni 2026
- Artikel 50 KI-Verordnung, deutsche Fassung (Lesehilfe)
- ActuIA: AI Act obligations in force and delays under Omnibus 2026/1744
- C2PA: Content Credentials 2.3 und fünf Jahre C2PA, Februar 2026
- SoftwareSeni: The C2PA Trust Layer in 2026 – Where It Works and Where It Breaks (u. a. mit Verweis auf World Privacy Forum)
- Bericht zum Reuters Institute Digital News Report 2026 (Sekundärquelle)
Der wöchentliche Klartext für Vorstände, CIOs und IT-Entscheider per E-Mail. Kapitel 1 des Buchs „Das CxO-Paradox“ gibt es schon jetzt als Vorabdruck – für alle, die Schwarzbrot Digital abonnieren.

DAS CxO-PARADOX
Wie falsche digitale Souveränität Wirtschaft und Staat entkernt und wie echte Unabhängigkeit gelingt.
Von Mathias Diwo · Executive Tech Advisor
- ✓ 6-Hebel-Plan: Geordneter Ausstieg aus VMware- & Hyperscaler-Lock-ins
- ✓ Board Scorecard: One-Page IT-Governance für Vorstand & Aufsichtsrat
- ✓ Sofort lesbar: Vollständiges Kapitel 1 als Vorab-Dossier
Strategische Vertiefung im gleichen Themencluster
Weiterführende Architektur- und Handlungsleitfäden für CIOs & IT-Entscheider.
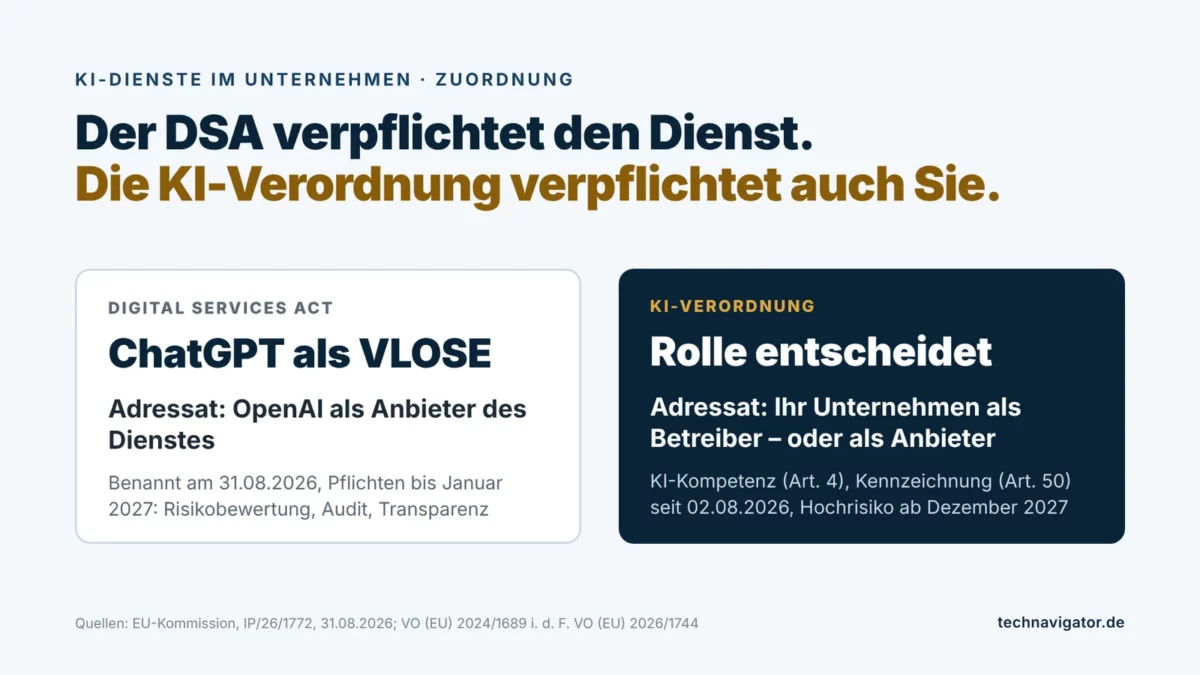
Welche Regeln gelten für ChatGPT – DSA oder AI Act? Eine Zuordnung für Unternehmen, die es einsetzen
Seit Ende August 2026 steht ChatGPT unter der strengsten Aufsicht des Digital Services Act, doch diese Pflichten treffen den Anbieter, nicht das Unternehmen, das den Dienst nutzt. Für das einsetzende Unternehmen entscheidet die KI-Verordnung, und dort hängt alles an der Rolle: Betreiber oder Anbieter.
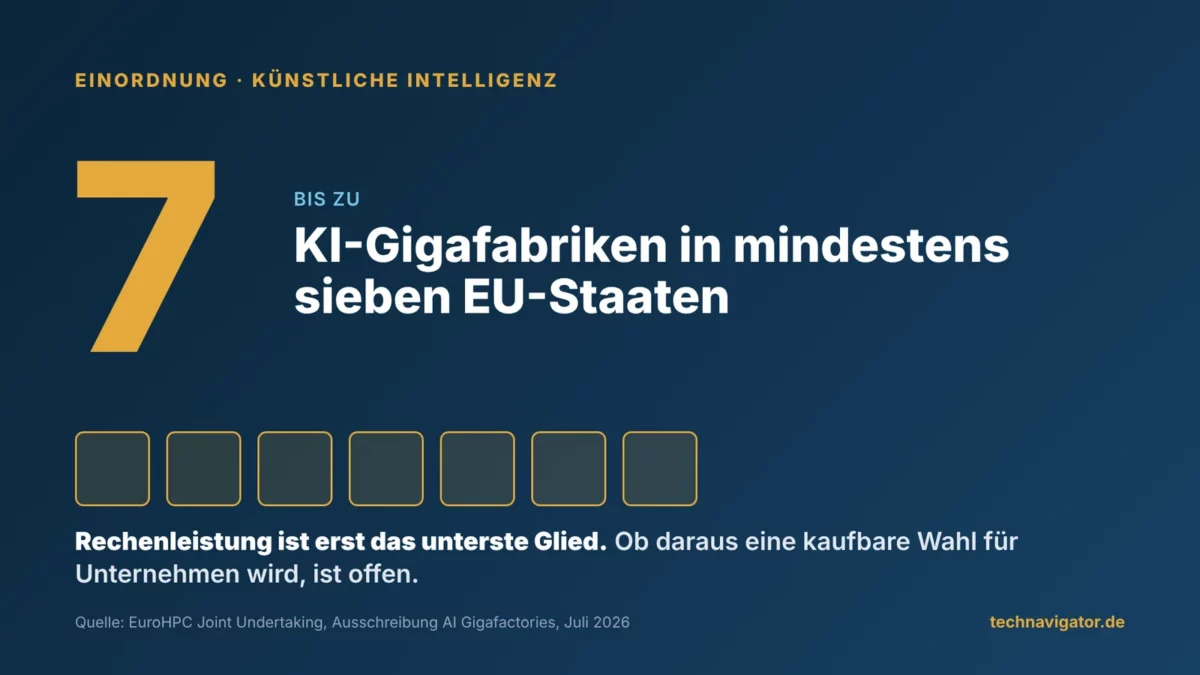
Sieben KI-Fabriken für Europa: Wer wird dort Kunde?
Am 12. November endet die EU-Ausschreibung für bis zu sieben KI-Gigafabriken. Für Unternehmen im DACH-Raum zählt weniger die Rechenleistung als die Frage, ob daraus ein kaufbares Angebot wird. Eine Einordnung.
Mathias Diwo
Herausgeber & Executive Tech AdvisorGründer von TechNavigator.de, Buchautor (HYBRID WORK) und strategischer Beirat für CIOs und Vorstände. Begleitet mittelständische Konzerne und Verwaltungsorganisationen bei Cloud-Exit-Strategien, NIS-2 Haftungsschutz und digitaler Souveränität.