
Die Nutzung US-basierter Cloud-KI birgt durch intransparente Datenverarbeitung und den CLOUD Act erhebliche Risiken für vertrauliche Betriebsgeheimnisse. Lokale Sprachmodelle mit Retrieval-Augmented Generation ermöglichen hochpräzise Unternehmens-KI bei lückenlosem Schutz des geistigen Eigentums.
DAS WICHTIGSTE IN KÜRZE
- Cloud-KI-APIs erzeugen Datenschutzrisiken und unkalkulierbare laufende Token-Kosten bei wachsendem Datenvolumen.
- Lokale LLMs erreichen auf modernen GPU-Servern die Inferenz-Leistung kommerzieller Modelle bei absoluter Datenhoheit.
- Enterprise RAG mit Vektordatenbanken (z. B. Qdrant) eliminiert Halluzinationen durch präzise Quellenbelege im Firmennetzwerk.
- Die Hardware-Anschaffungskosten amortisieren sich bei intensiver Nutzung bereits nach 6 bis 10 Monaten.
Fazit: Lokale KI-Infrastruktur als strategischer Wettbewerbsvorteil
Datensouveräne Enterprise-KI ist kein theoretisches Zukunftskonzept mehr, sondern bereits heute mit modernen Open-Weights-Modellen wie Llama 3.3, Mistral Large und hochperformanten Vektordatenbanken wie Qdrant im eigenen Rechenzentrum produktiv einsetzbar. Unternehmen müssen ihre sensiblen Konstruktionsdaten, Verträge, Quellcodes und Patientendaten nicht länger intransparenten US-Cloud-APIs anvertrauen.
Die Implementierung einer lokalen Retrieval-Augmented-Generation-Pipeline (RAG) vereint Spitzenleistungen bei der semantischen Wissenssuche mit minimalen Inferenz-Latenzen unter 50 Millisekunden und absoluter Datenhoheit. Die vollständige Kontrolle über Modell-Gewichte, Vektorräume und Zugriffsberechtigungen garantiert 100 % DSGVO-Konformität und schützt das geistige Eigentum dauerhaft vor unbefugtem Zugriff und externem KI-Training.
Das Dilemma der Cloud-KI: Innovationsdruck vs. Spionagerisiko
Der Innovationsdruck auf IT-Verantwortliche, produktive KI-Assistenten für Mitarbeiter bereitzustellen, ist enorm. Doch die unbedachte Anbindung kommerzieller Cloud-Modelle über Public APIs birgt fundamentale strategische und betriebswirtschaftliche Risiken, die vor allem in drei Kernbereichen zutage treten:
Daten-Exfiltration und der Verlust des geistigen Eigentums
Mitarbeiter kopieren unbemerkt Quellcode, patentierte Konstruktionsdetails, Kundenverträge oder vertrauliche Strategiepapiere in externe Chatfenster. Trotz gegenteiliger Marketing-Zusicherungen der US-Hyperscaler verbleiben Kontext-Prompts, Embedding-Vektoren und Metadatenströme auf Servern außerhalb europäischer Gerichtsbarkeit und unterliegen dem US CLOUD Act.
Für hochskalierende RAG-Pipelines empfiehlt sich die HNSW-Indizierung in Qdrant mit Scalar Quantization. Dadurch sinkt der RAM-Bedarf um 75 % bei nahezu identischer Retrieval-Präzision.
Hinzu kommt das strikte Verbot vieler Unternehmenskunden und Auditoren, sensible Projektdaten an externe US-KI-Dienste weiterzuleiten. Wer dies missachtet, riskiert den Verlust von ISO-27001-Zertifizierungen, TISAX-Freigaben und empfindliche Vertragsstrafen in regulierten Industriezweigen.
Besonders bei Fusionen, Übernahmen (M&A) und anstehenden Patentanmeldungen führt der Einsatz öffentlicher Chatbots zu unkontrollierbaren Spionagerisiken, da Konkurrenten oder ausländische Nachrichtendienste über unzureichend abgesicherte Cloud-Speicher Einblick in strategische Planungen gewinnen können.
Explodierende Token-Kosten und unberechenbare API-Gebühren
Bei hunderten aktiven Wissensarbeitern und automatisierten Batch-Verarbeitungen explodieren die monatlichen Token-Kosten exponentiell. Wer Millionen von Dokumentenseiten, E-Mails und Code-Repositories wiederholt analysiert, zahlt Monat für Monat hohe Gebühren für den Datendurchsatz – ohne jemals eigene digitale Vermögenswerte aufzubauen.
Ein mittelständischer Betrieb mit 200 Entwicklern und Analysten erreicht bei intensiver Nutzung mühelos monatliche API-Rechnungen von 10.000 bis 25.000 Euro. Bei lokaler GPU-Hardware hingegen sind die Inferenzkosten nach der Erstbeschaffung praktisch auf den reinen Stromverbrauch begrenzt.
Model-Drift, intransparente Updates und Abhängigkeiten
Ändert der Modellanbieter die Gewichte oder Sicherheitsfilter eines proprietären Sprachmodells, verändern sich Prompt-Ergebnisse und automatisierte Workflows unvorhersehbar. Zudem unterliegen Cloud-APIs strengen Rate-Limits und Drosselungen bei Lastspitzen.
Echte Reproduzierbarkeit und Compliance nach dem EU AI Act lassen sich nur auf Basis quelloffener, selbst gehosteter Modelle gewährleisten, deren Versionen exakt eingefroren, kontrolliert und im internen GitOps-Repository versioniert werden können.
Die On-Premises RAG-Pipeline: Architektur des Vektor-Tresors
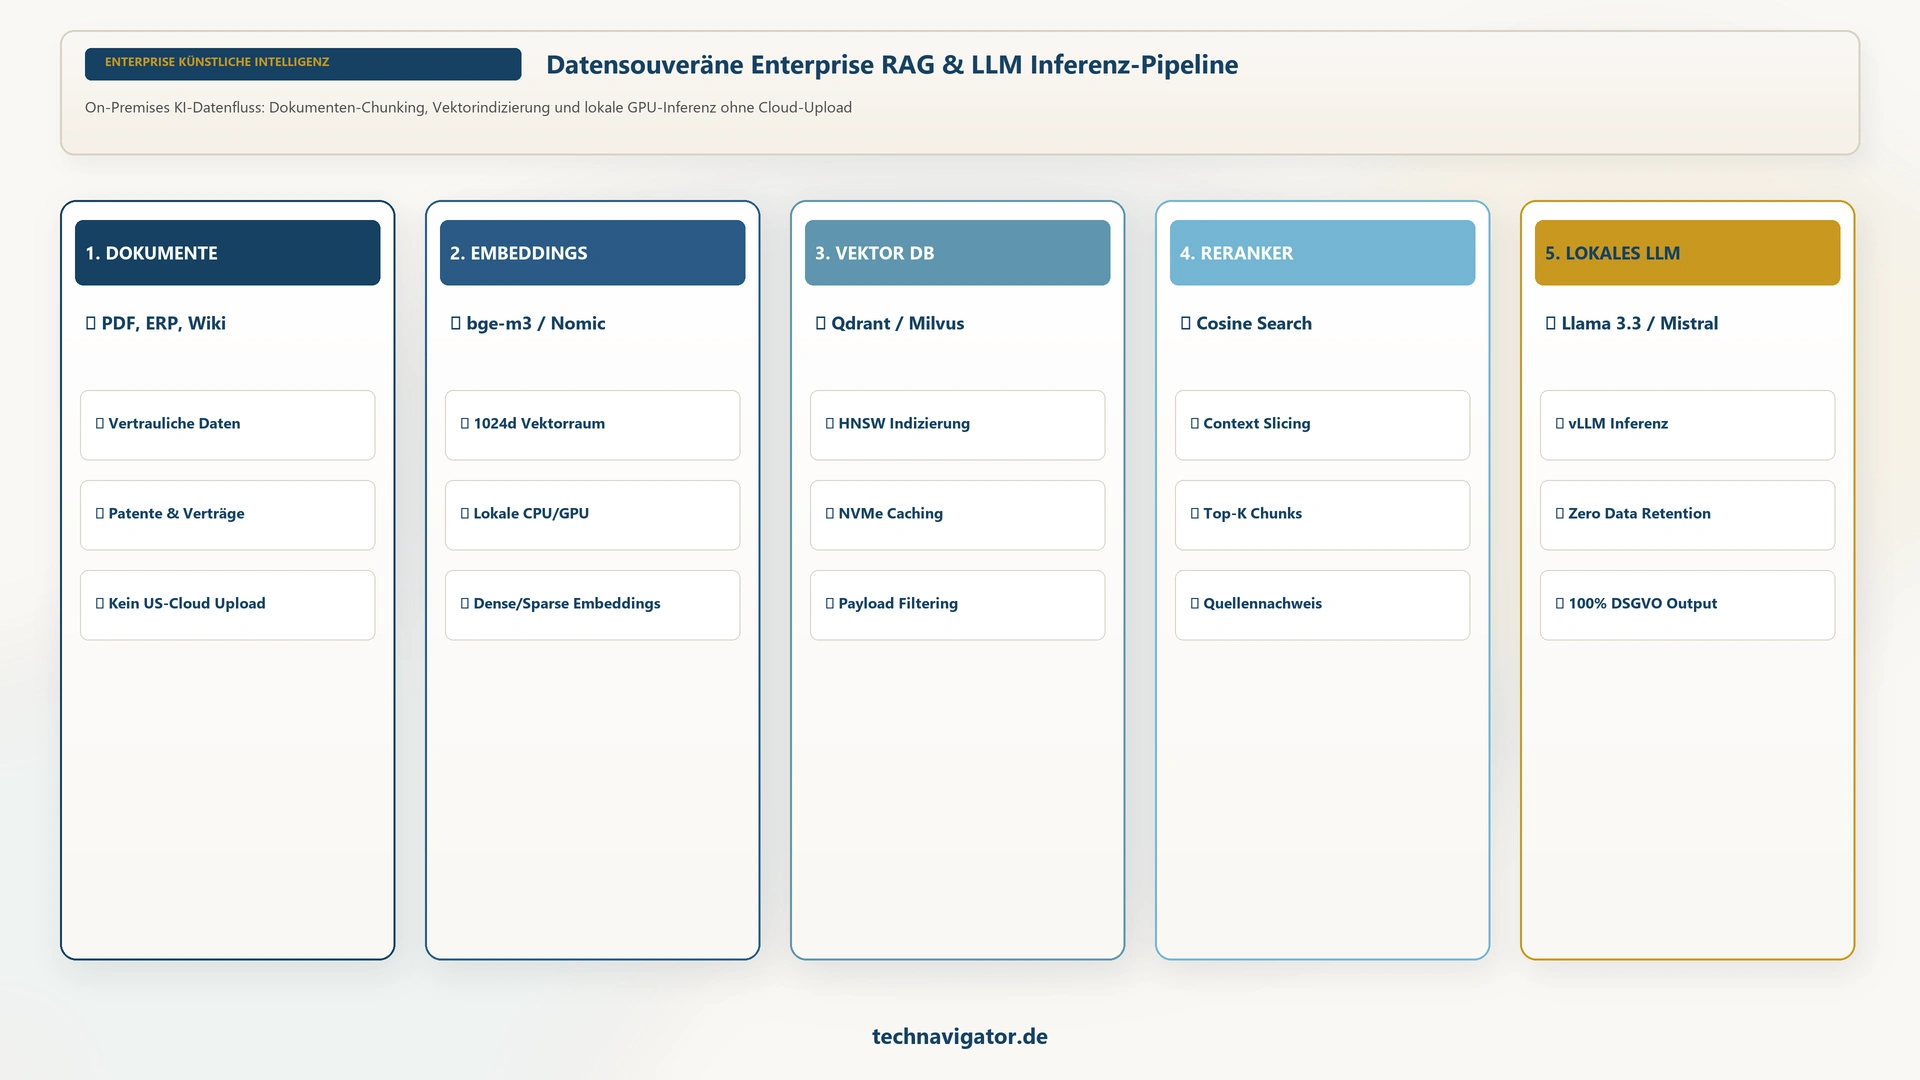
Die Lösung für anspruchsvolle Unternehmen liegt in der Kombination aus lokalen Open-Weight-Modellen und einer domänenspezifischen Retrieval-Augmented Generation (RAG) Pipeline. Die Architektur gliedert sich in drei hochperformante Funktionsebenen:
Dokumenten-Ingestion, Parsing und semantisches Chunking
Dokumente aus internen Netzlaufwerken, Confluence, ERP- und CRM-Systemen werden über Ingestion-Pipelines extrahiert, semantisch bereinigt, in strukturierte Chunks zerlegt und über lokale Embedding-Modelle (wie BAAI/bge-m3 oder multilingual-e5) in hochdimensionale Vektoren konvertiert.
Dabei kommen OCR-Engines (z. B. Tesseract oder docTR) für gescannte PDF-Dokumente und spezialisierte Parser für Tabellenstrukturen zum Einsatz, damit komplexe Bilanzen und Konstruktionsspezifikationen verlustfrei in Vektoren überführt werden. Ein automatisierter File-Watcher-Service aktualisiert geänderte Dokumente vollautomatisch im Hintergrund.
Die Vektordatenbank Qdrant und hybride Suchverfahren
Diese Vektoren werden in einer hochperformanten, lokalen Vektordatenbank wie Qdrant gespeichert. Stellt ein Mitarbeiter eine Frage, sucht das System über hybride Suchverfahren (Dense Vector Search kombiniert mit BM25 Keyword Search) die relevantesten Textpassagen im internen Vektortresor.
Die Benutzer-Authentifizierung bindet sich nahtlos an bestehende Single-Sign-On-Strukturen (Keycloak IAM) an. Vektoren werden mit Zugriffsattributen (ACLs) versehen, sodass Mitarbeiter in den Antworten ausschließlich Informationen aus Dokumenten erhalten, für die sie eine explizite Leseberechtigung besitzen.
Lokale Inferenz mit vLLM und quantisierten Sprachmodellen
Die gefundenen Fakten werden zusammen mit der Frage an das lokale Sprachmodell (z. B. Llama 3 70B oder Mixtral 8x22B) übergeben, das über optimierte Inferenz-Engines wie vLLM auf dedizierten GPU-Servern betrieben wird.
Dank PagedAttention, Tensor Parallelism über mehrere GPUs und moderner AWQ-Quantisierung erreichen lokale Server Inferenz-Geschwindigkeiten von 30 bis 60 Tokens pro Sekunde. Die Antworten sind deterministisch, enthalten klickbare Quellennachweise auf interne Dokumente und schließen Halluzinationen systematisch aus.
Systemvergleich: Public Cloud API vs. Lokaler RAG-Stack
Für Führungskräfte und IT-Architekten ist die Wahl der richtigen KI-Plattform eine fundamentale Weichenstellung. Der direkte Systemvergleich stellt die wirtschaftlichen und technischen Vorzüge beider Ansätze gegenüber:
Datensicherheit, Rechteverwaltung und DSGVO-Konformität
Während Public APIs bei gelegentlichen Einzelanfragen bequem erscheinen, führt kein Weg an einem lokalen RAG-Stack vorbei, sobald geschäftskritische Datenbestände im Spiel sind. Unternehmen erlangen die volle Hoheit über ihre Trainings- und Kontextdaten zurück und schützen ihre wertvollsten Geschäftsgeheimnisse vor externem Zugriff.
Auditoren und Datenschutzbeauftragte können jede Datenübertragung im lokalen Netzwerk über Wireshark und Prometheus lückenlos überwachen – ein Sicherheitsniveau, das bei US-Cloud-Diensten prinzipbedingt unmöglich ist.
Wirtschaftlichkeit und Amortisation auf dedizierter GPU-Hardware
Auch betriebswirtschaftlich punktet der lokale Betrieb: Einmal angeschaffte Serverhardware erzeugt keine variablen Kosten pro Anfrage. Entwicklerteams können unbegrenzt experimentieren, interne Datensätze indizieren und automatisierte Workflows skalieren, ohne das monatliche IT-Budget zu belasten.
Die Anschaffung eines GPU-Servers mit zwei NVIDIA L40S oder A100 Karten (ca. 25.000 Euro) amortisiert sich bei mittlerer Auslastung bereits nach 6 bis 10 Monaten gegenüber Cloud-API-Abrechnungen. Über eine 3-jährige Nutzungsdauer spart ein Unternehmen so über 70.000 Euro an laufenden Kosten ein.
Feinabstimmung und Anpassung an unternehmenseigenes Vokabular
Zusätzlich ermöglicht der lokale Betrieb maßgeschneiderte Fine-Tunings: Sprachmodelle können über LoRA-Adapter (Low-Rank Adaptation) auf das spezifische Firmen-Vokabular, Produktbezeichnungen und interne Abkürzungen nachtrainiert werden, ohne dass sensible Trainingsdaten an Dritte abfließen.
Die 3 teuersten Architektur-Fehler bei On-Premises RAG
Beim Aufbau lokaler RAG-Systeme scheitern viele Pilotprojekte an typischen architektonischen Fehlentscheidungen. IT-Architekten sollten folgende drei Fehlerquellen gezielt vermeiden:
Fehler 1: Naives Chunking ohne semantische Struktur
Das starre Zerschneiden von PDFs und Word-Dateien nach fixer Zeichenanzahl (z. B. 500 Zeichen) zerstört Tabellen, Fußnoten und logische Sinnabschnitte. Die professionelle Lösung ist strukturbezogenes Markdown-Parsing mit Document-Layout-Analysis und hierarchischem Chunking (Parent-Child-Retriever).
Dabei wird ein semantischer Overlap von 10 bis 15 Prozent definiert, damit Schlüsselbegriffe an Abschnittsgrenzen nicht aus dem thematischen Kontext gerissen werden.
Fehler 2: Fehlende rollenbasierte Zugriffskontrolle (RBAC)
Wenn die Vektorsuche Zugriffsrechte ignoriert, beantwortet der Bot die Frage eines Werkstudenten mit sensiblen Gehaltslisten der Geschäftsführung. Vektoren müssen beim Ingestion-Prozess zwingend mit ACL-Metadaten (Keycloak Gruppen) angereichert und vor dem Retrieval gefiltert werden.
Das System erzwingt die Autorisierungsprüfung direkt im Vektor-Filter von Qdrant, bevor der Kontext an das Sprachmodell übergeben wird.
Fehler 3: GPU-Fehlplanung und falsche Inferenz-Engines
Der Einsatz unoptimierter HuggingFace-Pipelines führt zu Speicher-Fragmentierung und extrem langsamer Antwortgenerierung bei parallelen Anfragen. Enterprise-Inferenz erfordert Engines wie vLLM oder TensorRT-LLM mit dynamischem Batching und PagedAttention für maximalen Durchsatz.
Zudem sollte der Grafikspeicher (VRAM) so dimensioniert werden, dass Modellgewichte und KV-Cache für mindestens 16 parallele Sessions vollständig im VRAM Platz finden.
Unternehmenswissen als souveräner Wettbewerbsvorteil
Künstliche Intelligenz entfaltet ihre stärkste Hebelwirkung, wenn sie tief und sicher in die internen Datenbestände eines Unternehmens integriert ist. Lokale LLMs und Enterprise RAG beweisen eindrucksvoll, dass technologische Spitzenleistung und kompromissloser Datenschutz keine Gegensätze sind:
Schutz des Firmenkapitals durch autarke Inferenz
Wer die eigene KI-Infrastruktur auf dedizierter Hardware im eigenen Rechenzentrum aufbaut, schützt sein wertvollstes Betriebsvermögen, eliminiert laufende Lizenzkosten und sichert sich einen nachhaltigen Wettbewerbsvorsprung im Zeitalter der generativen Transformation.
Geschäftsgeheimnisse, Rezepturen und Kundenbeziehungen bleiben dauerhaft im Besitz des Unternehmens – geschützt vor fremdem Zugriff und geopolitischen Risiken.
Unabhängigkeit von US-Modellanbietern und Preisdiktaten
Souveräne KI ist das Fundament einer zukunftsfähigen Digitalstrategie. Unternehmen, die heute eigene Kompetenzen aufbauen und offene Modelle beherrschen, bleiben unabhängig von den Geschäftsmodellen und Preisdiktaten der US-Technologiegiganten.
