
Blockchain-Architekturen im Konzern-Audit: Merkle Trees, Hash-Ketten und Konsensprotokolle
Executive Summary
- ✓Kryptografische Baukästen statt Magie: Eine Blockchain kombiniert bekannte Informatik-Grundlagen aus kryptografischen SHA-256- oder SHA-3-Hash-Ketten, binären Merkle-Bäumen, asymmetrischen Signaturen (Ed25519) und verteilten Konsensprotokollen.
- ✓Logarithmische Prüfpfade O(log n): Binäre Merkle Trees verdichten tausende Einzelbuchungen zu einem einzigen Wurzel-Hash und ermöglichen Wirtschaftsprüfern die mathematische Einschlussprüfung ohne vollständige Replikation des Datenbestands.
- ✓Konsens-Overhead in B2B-Netzen: Byzantinische Fehlertoleranz (BFT) erzeugt quadratische Kommunikationslast zwischen Knoten, während Crash-Fault-Tolerant-Protokolle wie Raft in vertraglich regulierten Rechenzentren tausendfach schneller arbeiten.
- ✓DSGVO**-Konformität und 80 Prozent TCO*-Vorteil: Erst die Trennung von Off-Chain-Nutzdaten in relationalen B-Tree-Datenbanken und On-Chain-Hash-Verankerung nach IETF RFC 6962 löst den Löschkonflikt aus Artikel 17 DSGVO wirtschaftlich.
In kaum einer Disziplin der Unternehmens-IT klaffte die Lücke zwischen den Versprechungen der Marketingabteilungen und der nüchternen Systemarchitektur so weit auseinander wie bei Distributed-Ledger-Technologien (DLT). Über Jahre hinweg wurden Blockchains auf Vorstandskonferenzen als universelle Vertrauensmaschine präsentiert, die Handelsregister, Lieferketten und Finanzbuchhaltungen gleichermaßen ablösen sollte.
Für CIOs, Chief Information Security Officers und Enterprise-Architekten im Konzern-Audit ist es zwingend geboten, diese spekulative Rhetorik vollständig auszublenden. Eine belastbare Architekturentscheidung verlangt die präzise Zerlegung des Systems in seine mathematischen, datenstrukturellen und netzwerkprotokollarischen Einzelteile.
Nimmt man eine Blockchain im technischen Audit auseinander, findet sich darin keine einzige übernatürliche Neuerung. Stattdessen stößt der Prüfer auf eine spezifische Kopplung von Verfahren, die in der angewandten Kryptografie und der Theorie verteilter Systeme seit den späten 1970er und 1980er Jahren dokumentiert sind: kollisionsresistente Einweg-Hashfunktionen, binäre Merkle-Bäume, digitale Signaturen und Konsensalgorithmen.
Die entscheidende Ingenieursfrage im Rechenzentrum lautet daher niemals, ob eine Blockchain technisch funktioniert, sondern welchen Preis eine Organisation in Form von Durchsatzverlust, Latenz, Speicherreplikation und Betriebskosten für ihre Eigenschaften zahlt. Dieser Leitfaden seziert die Architektur Schicht für Schicht und zeigt auf, wann ein verteiltes Ledger gerechtfertigt ist und wann kryptografische Append-Only-Logs auf Standard-Datenbanken überlegen sind.
Kryptografische Hash-Ketten und binäre Merkle Trees: Die Mathematik der Unveränderbarkeit
Das zentrale Sicherheitsversprechen jeder Blockchain ist die nachträgliche Unveränderbarkeit (Immutability) einmal bestätigter Transaktionsdaten. Technisch ruht dieses Fundament auf kryptografischen Hash-Funktionen wie SHA-256 (aus der SHA-2-Familie) oder den Schwamm-Konstruktionen von SHA-3 (Keccak), wie sie das Bundesamt für Sicherheit in der Informationstechnik in der Richtlinie BSI TR-02102 spezifiziert.
Eine solche Hash-Funktion bildet einen beliebig großen Eingabedatenstrom deterministisch auf einen Bitstring fester Länge von 256 Bit ab. Dabei gelten drei strenge mathematische Eigenschaften: Erstens die Einwegeigenschaft (Preimage Resistance), sodass aus dem Prüfsumme-Digest niemals auf den Klartext zurückgerechnet werden kann; zweitens die schwache und starke Kollisionsresistenz, die verhindert, dass zwei unterschiedliche Datensätze denselben Hashwert erzeugen; und drittens der Lawineneffekt (Avalanche Effect).
Dieser Lawineneffekt sorgt dafür, dass bereits die Manipulation eines einzigen Bits in einer Rechnungsnummer oder einem Buchungsbetrag etwa die Hälfte aller 256 Ausgabebits völlig unvorhersehbar kippen lässt. In einer linearen Hash-Kette enthält jeder neue Block in seinem Block-Header den exakt 32 Byte langen SHA-256-Hash des unmittelbar vorangegangenen Block-Headers, wodurch eine chronologische Kausalitätskette entsteht.
Verändert ein Angreifer oder ein kompromittierter Datenbankadministrator einen historischen Datensatz in Block 1.000, verändert sich zwangsläufig der Hash dieses Blocks. Da Block 1.001 jedoch den ursprünglichen Hashwert von Block 1.000 in seinem Header trägt, bricht die kryptografische Verknüpfung sofort auf. Um die Manipulation zu vertuschen, müsste der Angreifer sämtliche nachfolgenden Block-Header bis zur aktuellen Spitze der Kette neu berechnen.
Architektonischer Blindspot: Die teure Verwechslung von Merkle-Datenstruktur und Konsensnetzwerk
In zahlreichen IT-Lenkungsausschüssen wird die mathematische Revisionssicherheit von Hash-Ketten fälschlicherweise mit einem verteilten Blockchain-Netzwerk gleichgesetzt. Doch die fälschungssichere Verkettung durch Merkle-Bäume ist eine reine Datenstruktur, die in Git oder in Certificate-Transparency-Logs nach IETF RFC 6962 seit Jahren ohne Token, Miner oder P2P-Konsens produktiv läuft. Wer lediglich einen manipulationssicheren Audit-Trail benötigt, braucht kein schwerfälliges Distributed-Ledger-Konsortium.
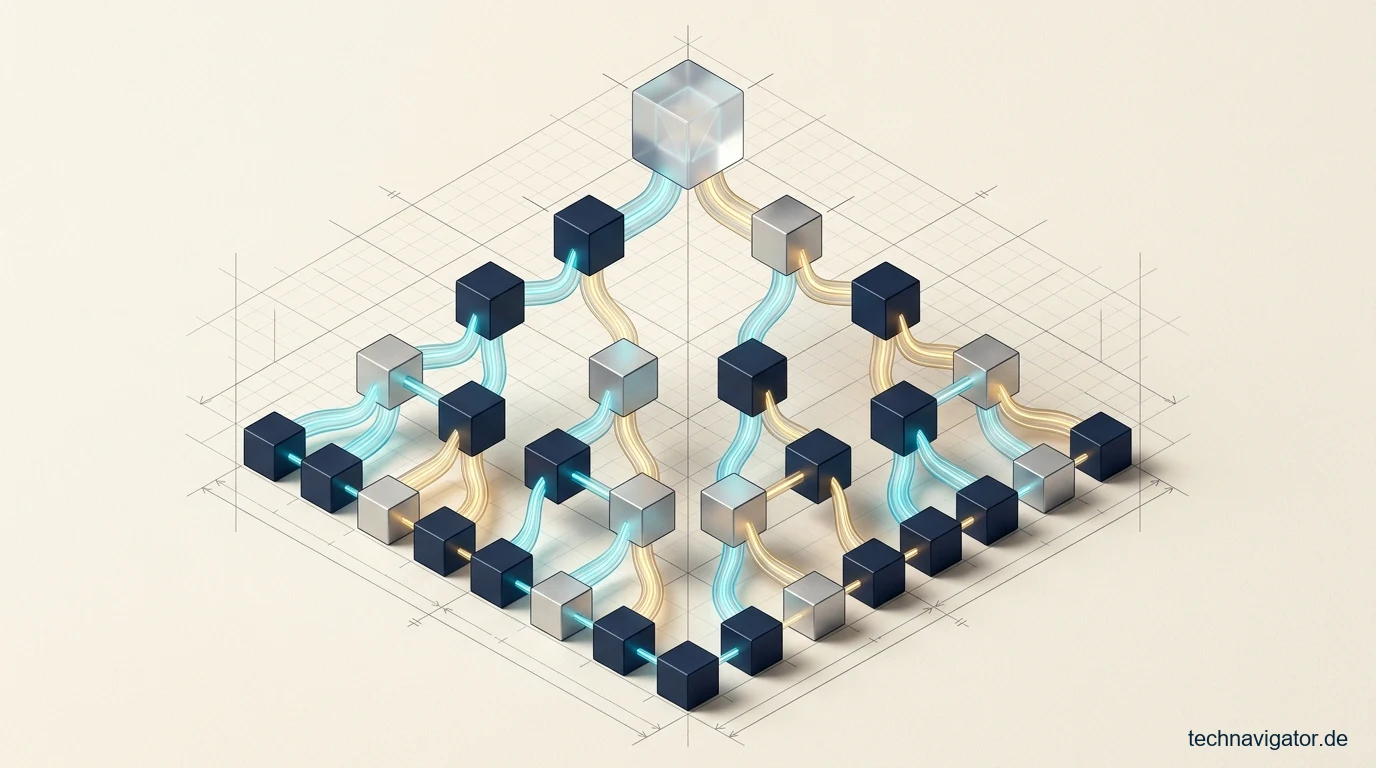
Damit ein Prüfer bei Millionen von Einzelbuchungen nicht für jede Verifikation den gesamten Blockinhalt sequenziell einlesen muss, ordnet die Architektur die Transaktionen innerhalb eines Blocks in einem binären Merkle Tree an. Jede einzelne Transaktion wird zunächst gehasht und bildet einen Blattknoten (Leaf Node) am unteren Rand des Baums. Anschließend werden jeweils zwei benachbarte Blatt-Hashes verkettet und erneut gehasht, um den darüberliegenden Elternknoten zu bilden.
Logarithmische Merkle-Inclusion-Proofs in O(log n) ohne Vollreplikation
Diese paarweise Verdichtung wiederholt sich über alle Baumebenen hinweg, bis an der Spitze exakt ein einziger 256-Bit-Wert verbleibt: die Merkle Root, die im Block-Header gespeichert wird. Für das Konzern-Audit entfaltet diese Struktur einen enormen Effizienzvorteil, da sie sogenannte Merkle Inclusion Proofs (Audit-Pfade) mit einer logarithmischen Komplexität von O(log n) erlaubt.
Umfasst ein Datenblock beispielsweise 65.536 einzelne Buchungssätze, muss ein externer Wirtschaftsprüfer oder ein leichtgewichtiger Prüf-Client (Light Node) keineswegs alle 65.536 Transaktionen über das Netzwerk herunterladen, um die unverfälschte Existenz einer einzelnen Buchung zu beweisen. Es genügt vollkommen, wenn ihm das System die exakt 16 Geschwister-Hashes (Sibling Hashes) entlang des Pfades vom Blattknoten bis zur bekannten Merkle Root übermittelt.
Mit lediglich 16 Hash-Operationen (insgesamt nur 512 Byte an Prüfdaten) berechnet der Auditor in Bruchteilen einer Millisekunde die Wurzel nach und gleicht sie mit dem signierten Block-Header ab. Stimmen beide Werte überein, ist mathematisch zweifelsfrei bewiesen, dass die geprüfte Buchung zum Zeitpunkt der Blockversiegelung exakt in dieser Form vorlag, ohne dass Geschäftsgeheimnisse aus den übrigen 65.535 Transaktionen offengelegt werden müssen.
Ergänzt wird diese Datenintegrität durch asymmetrische Kryptografie zur Urheberschaftssicherung. Bevor ein Datensatz in den Merkle-Baum gelangt, signiert das erzeugende System den Transaktions-Hash mit seinem privaten Schlüssel über elliptische Kurven wie ECDSA oder das gegen Seitenkanalangriffe gehärtete Ed25519-Verfahren. Wie Unternehmen diese kritischen Signaturschlüssel vor Kompromittierung schützen, analysieren wir detailliert in unserem Leitfaden zu Hardware Security Modules (HSM) und Private-Key-Custody nach FIPS 140-3.
Ergänzende Architektur-Analysen und technische Entscheidungsmatrizen für Ihre IT-Planung finden Sie in unseren weiterführenden Leitartikeln zu Private Blockchain im Enterprise-Einsatz sowie zu B2B-Blockchain im Enterprise-Einsatz.
Append-Only-State-Logs versus relationale B-Trees: Datenstrukturen im Systemvergleich
Warum lassen sich geschäftskritische ERP- oder Kernbankensysteme nun nicht einfach komplett auf eine solche Blockchain-Datenstruktur umstellen? Die Antwort liegt im fundamentalen Gegensatz zwischen einem unveränderbaren Append-Only-Log und den veränderlichen B-Tree-Speicherstrukturen (Mutable State) klassischer relationaler Datenbankmanagementsysteme wie PostgreSQL.
Relationale Datenbanken sind über Jahrzehnte darauf optimiert worden, den aktuellen Systemzustand mit minimaler I/O-Latenz abzubilden und zu aktualisieren. Führt eine Applikation in PostgreSQL eine UPDATE- oder DELETE-Anweisung aus, greift die Engine über balancierte B-Tree-Indizes in O(log n) auf die betreffende 8-Kilobyte-Datenseite (Heap Page) zu, schreibt das Vorab-Protokoll in das Write-Ahead-Log (WAL) und erzeugt über Multi-Version Concurrency Control (MVCC) ein neues Datentupel.
„Eine Blockchain ersetzt keine relationale Transaktionsdatenbank, sondern kehrt deren Speicherprinzip um: Wo PostgreSQL veraltete Zustände per Garbage Collection bereinigt, erzwingt das Ledger die ewige Mitführung jeder historischen Zustandsänderung auf jedem einzelnen Knoten.“
Sobald keine laufende Lesetransaktion mehr auf die veraltete Version des Datensatzes zugreift, gibt der Hintergrundprozess (Autovacuum) den physischen Speicherplatz auf den NVMe-Laufwerken wieder frei. Dadurch bleibt das Datenvolumen einer operativen Tabelle selbst bei Milliarden von Kontobewegungen kompakt, während komplexe analytische Joins über Fremdschlüssel in Millisekunden ausgeführt werden.
Eine Blockchain hingegen kennt konstruktionsbedingt kein Überschreiben und keine Speicherbereinigung historischer Blöcke. Jede Korrektur eines fehlerhaften Stammdatensatzes erfordert eine neue Kompensationstransaktion, die zusätzlich an das Ende des Ledgers angehängt wird. Da zudem jeder Validierungsknoten im Netzwerk eine vollständige Kopie des gesamten State-Tries und der Blockhistorie vorhalten muss (State Bloat), wächst der Speicher- und IOPS-Bedarf linear mit jeder einzelnen Schreiboperation an.
Byzantinische Fehlertoleranz (BFT) versus Crash Fault Tolerance (Raft und Paxos)
Noch gravierender fällt der architektonische Unterschied auf der Netzwerkebene aus, sobald mehrere Serverknoten über die Reihenfolge eingehender Transaktionen entscheiden müssen. In der verteilten Informatik unterscheidet man hier strikt zwischen zwei Fehlermodellen: Crash Fault Tolerance (CFT) und Byzantine Fault Tolerance (BFT).
Etablierte Enterprise-Cluster wie etcd in Kubernetes, CockroachDB, Patroni-PostgreSQL oder Ceph nutzen CFT-Konsensprotokolle wie Raft oder Paxos. Diese Algorithmen garantieren konsistente Datenhaltung, solange eine einfache Mehrheit der Knoten (2f + 1 Knoten für f Ausfälle) erreichbar ist. Raft setzt voraus, dass alle Server derselben Administration unterliegen und bei Defekten zwar ausfallen, aber niemals absichtlich gefälschte Protokollnachrichten senden.
Der Kommunikationsaufwand von Raft skaliert daher linear mit O(n): Ein gewählter Leader-Knoten nimmt Schreibaufträge entgegen, repliziert die Log-Einträge parallel an die Follower und bestätigt den Commit, sobald das Mehrheitsquorum geantwortet hat. Innerhalb eines Rechenzentrumsverbunds dauert dieser deterministische Konsens weniger als zwei bis fünf Millisekunden bei Durchsatzraten von mehreren zehntausend Transaktionen pro Sekunde.
Blockchains wurden demgegenüber für feindselige Umgebungen entworfen, in denen Knoten durch potenziell arglistige Parteien betrieben werden (byzantinisches Fehlermodell). Während öffentliche Netzwerke über Proof-of-Work oder Proof-of-Stake Sybil-Angriffe abwehren, setzen private Unternehmens-Blockchains auf BFT-Protokolle wie PBFT, Tendermint oder HotStuff. Die energetischen und protokollarischen Grenzen analysiert unser Beitrag zu Proof-of-Work, Proof-of-Stake und BFT-Konsens im Enterprise-Audit.
Um maximal f manipulierende Sabotage-Knoten zu überstimmen, benötigt ein BFT-Cluster mindestens 3f + 1 Knoten. In klassischen PBFT-Implementierungen muss zudem jeder Validierungsknoten in mehrstufigen Abstimmungsphasen (Pre-Prepare, Prepare, Commit) signierte Nachrichten mit jedem anderen Knoten austauschen. Diese quadratische Nachrichtenkomplexität von O(n²) führt dazu, dass bei 30 Konsortialpartnern tausende Netzwerkpakete pro Block den Durchsatz einbrechen lassen.
Architektur- und Audit-Matrix: Blockchain-Varianten versus kryptografische SQL-Cluster
Steht ein Architekturboard vor der Aufgabe, ein revisionssicheres Buchungs- oder Nachweissystem zu entwerfen, müssen sämtliche Systemeigenschaften nüchtern gegeneinander abgewogen werden. In über 90 Prozent der B2B-Projekte, in denen alle Teilnehmer über Handelsregistereinträge, TLS-Zertifikate und zivilrechtliche Rahmenverträge identifiziert sind, existiert überhaupt kein byzantinisches Angriffsmodell, das den immensen Overhead einer DLT rechtfertigen würde.
Die folgende Bloomberg-Radar-Matrix vergleicht öffentliche Blockchains sowie private Konsortial-DLTs direkt mit einer modernen Enterprise-Referenzarchitektur aus hochverfügbarem PostgreSQL-Cluster (Raft-CFT) und kryptografischer Merkle-Tree-Verankerung nach IETF RFC 6962:
| Architektur- & Audit-Kriterium | Blockchain / Permissioned DLT (PoS & PBFT) | PostgreSQL HA-Cluster + RFC-6962-Merkle-Log | CIO-Bewertung |
|---|---|---|---|
| 1. Konsens & Nachrichtenlast | Byzantinischer Konsens (3f+1 Knoten) mit quadratischer O(n²) Nachrichtenkomplexität und mehrstufigen Signaturrunden. | Crash Fault Tolerance (Raft 2f+1) mit linearer O(n) Replikation zwischen autorisierten Rechenzentrumsknoten. |
Raft-VorteilKein O(n²)-Netzwerkstau
|
| 2. Durchsatz & Commit-Latenz | 15 bis 500 Transaktionen pro Sekunde; Finalitätslatenz zwischen 1 Sekunde (BFT) und mehreren Minuten (Public Chain). | Über 25.000 ACID-Transaktionen pro Sekunde bei deterministischer Schreib-Finalität unter 5 Millisekunden. |
Echtzeitfähig100x höherer OLTP-Durchsatz
|
| 3. Prüfpfad & Manipulation | SHA-256-Blockverkettung und Merkle Trees erzwingen Unveränderbarkeit, erfordern aber volle Node-Synchronisation. | Identische O(log n) Merkle-Inclusion-Proofs nach RFC 6962 plus HSM-Zeitstempel auf WORM-Speicher ohne P2P-Ballast. |
BeweisäquivalentVolle GoBD-/BSI-Prüfbarkeit
|
| 4. DSGVO Art. 17 (Löschrecht) | On-Chain-Speicherung personenbezogener Daten verstößt irreversibel gegen das gesetzliche Recht auf Löschung. | Physische Löschung im B-Tree jederzeit möglich; im Merkle-Log verbleibt nur ein gepfefferter, wertloser Blind-Hash. |
DLT-HaftungsrisikoOff-Chain-Haltung zwingend
|
| 5. 60-Monats-TCO & Betrieb | Hohe Spezialistenkosten, komplexe Smart-Contract-Audits und redundante Multi-Party-Knoteninfrastruktur. | Betrieb durch bestehende Linux- und Datenbank-Teams auf vorhandener Standard-Infrastruktur ohne Lizenzaufschlag. |
Über 80 % ErsparnisNiedrigste Betriebskosten
|
Die Gegenüberstellung zeigt deutlich, dass sich die kryptografische Beweiskraft eines Merkle-Baums vollständig von der schwerfälligen Netzwerktopologie einer Blockchain entkoppeln lässt. Ein Unternehmen erhält exakt dieselbe mathematische Manipulationssicherheit, wenn es seine Transaktionen in einer hochperformanten relationalen Datenbank verarbeitet und lediglich die komprimierten Merkle-Wurzel-Hashes in einem Append-Only-Transparenzregister nach IETF RFC 6962 versiegelt.
Der regulatorische Konflikt mit DSGVO Artikel 17 und Off-Chain-Hash-Anchoring
Neben der reinen Systemperformance erweist sich im europäischen Rechtsraum vor allem die Datenschutz-Grundverordnung (DSGVO) als härtester Prüfstein für jede Blockchain-Architektur. Artikel 17 der DSGVO verbrieft betroffenen Personen das unveräußerliche Recht auf unverzügliche Löschung („Recht auf Vergessenwerden“), sobald der Verarbeitungszweck entfällt oder eine Einwilligung widerrufen wird.
Hier prallen zwei unvereinbare Designprinzipien frontal aufeinander: Während das Datenschutzrecht die restlose physische Vernichtung personenbezogener Datensätze verlangt, ist eine Blockchain mathematisch exakt darauf ausgelegt, jede nachträgliche Löschung unmöglich zu machen. Werden Kundennummern, E-Mail-Adressen, Lieferanschriften oder Mitarbeiterkennungen im Klartext in einen Block geschrieben, lässt sich dieser Verstoß technisch nie wieder heilen, ohne die gesamte Kette ab diesem Block zu verwerfen.
Auch das bloße Hashen oder symmetrische Verschlüsseln personenbezogener Daten vor dem Schreiben in die Blockchain (On-Chain) reicht nach ständiger Auslegung der europäischen Datenschutzaufsichtsbehörden nicht für eine Anonymisierung aus. Nach Erwägungsgrund 26 der DSGVO gelten verschlüsselte oder gehashte Attribute weiterhin als pseudonyme, personenbezogene Daten, solange ein Zuordnungsschlüssel existiert oder einfache Hashwerte über Rainbow-Tables bzw. Brute-Force-Angriffe rückrechenbar sind.
Zudem unterliegen kryptografische Verschlüsselungsverfahren einer natürlichen Alterung über die Jahrzehnte. Wird ein heute auf einer Blockchain gespeicherter Chiffretext in zehn Jahren durch leistungsfähigere Hardware oder Quantenalgorithmen gebrochen, liegt der Personenbezug plötzlich für alle Netzwerkteilnehmer offen, selbst wenn der ursprüngliche Entschlüsselungsschlüssel längst vernichtet wurde (sogenanntes Crypto-Shredding-Risiko).
Die einzige rechtssichere und zugleich auditfeste Architektur besteht daher im strikten Off-Chain-Payload-Referencing mit kryptografischer Hash-Verankerung (Hash Anchoring). Dabei verbleiben sämtliche fachlichen Nutzdaten und personenbezogenen Attribute ausschließlich in einer geschützten relationalen Datenbank (Off-Chain), wo sie granularen Zugriffskontrollen und regulären Löschroutinen nach Artikel 17 DSGVO unterliegen.
Für den Manipulationsschutz berechnet das System aus dem Datensatz und einem zufälligen 256-Bit-Geheimwert (Cryptographic Salt) einen SHA-256-Hash für den Merkle-Baum. Bei einer Löschanfrage entfernt die Datenbank den Klartext samt Salt restlos aus dem B-Tree. Der verbleibende Hash im Merkle-Log ist ohne das Salt informationstheoretisch wertlos, während alle übrigen Audit-Pfade des Baums zu 100 Prozent intakt und prüfbar bleiben.
Vollkostenrechnung über 60 Monate und die Make-or-Buy-Sourcing-Weiche
Um die wirtschaftlichen Konsequenzen für den Finanzvorstand (CFO) transparent zu beziffern, betrachten wir ein reales Konzern-Szenario: Ein Industrieunternehmen möchte jährlich rund 50 Millionen Lieferketten-, Qualitäts- und Zahlungsfreigabe-Ereignisse über fünf Gesellschaften und Zulieferer hinweg manipulationssicher für externe Audits protokollieren. Wann sich ein solches Vorhaben kaufmännisch überhaupt trägt, untersuchen wir vertiefend in unserer Analyse zum Business Case und der TCO-Realität von Enterprise-DLT.
Entscheidet sich das Unternehmen für den Aufbau einer privaten Konsortial-Blockchain (etwa auf Basis von Hyperledger Fabric oder Quorum mit BFT-Konsens), müssen mindestens fünf dedizierte Validierungsknoten samt Orderer-Services, Peer-Datenbanken (CouchDB/LevelDB) und spezialisierten PKI-Zertifikatsstellen dauerhaft betrieben werden. Hinzu kommen initiale Projektkosten von rund 420.000 Euro für Chaincode-Entwicklung, Sicherheits-Audits der Smart Contracts und die Integration der Off-Chain-Datenhaltung.
Im laufenden Betrieb verschlingt die DLT-Infrastruktur durch Cloud-Managed-Blockchain-Aufschläge, Multi-Node-Replikation und die Bindung rar gesäter DLT-Spezialisten (mindestens 1,5 FTE zu je 135.000 Euro Jahresgehalt) rund 310.000 Euro pro Jahr. Über den Betrachtungszeitraum von 60 Monaten (fünf Jahre) summiert sich die Total Cost of Ownership der Blockchain-Lösung damit auf 1,97 Millionen Euro.
Realisiert dasselbe Unternehmen den Revisionsschutz über ein hochverfügbares PostgreSQL-Cluster (drei Knoten mit Raft/Patroni-Failover) samt RFC-6962-Merkle-Tree-Struktur und periodischer HSM-Zeitstempelung, sinkt das Initialbudget auf 95.000 Euro. Da das bestehende Datenbank-Team den Stack ohne Zusatzlizenzen betreut, liegen die jährlichen Betriebskosten bei 48.000 Euro, was über 60 Monate 335.000 Euro Gesamtkosten und 1,635 Millionen Euro Einsparung (83 Prozent TCO-Reduktion) bedeutet.
Für die praktische Beschaffung und Umsetzung eines solchen kryptografischen Audit-Systems stehen IT-Verantwortlichen drei klar abgegrenzte Bereitstellungsmodelle zur Auswahl, die sich nach der internen Betriebsreife und der regulatorischen Nachweispflicht richten. Weitere Kriterien zur Plattformwahl bietet unser Leitfaden zur Enterprise DLT und Blockchain Due Diligence.
Erstens (Eigenbetrieb): Konzerne und gehobene Mittelständler mit eigenem Datenbank- und Security-Team implementieren das Append-Only-Merkle-Log direkt auf ihren bestehenden PostgreSQL-Clustern im eigenen Rechenzentrum. Die Unveränderbarkeit wird auf Speicherebene durch WORM-geschützte Backups (Object Lock) und auf mathematischer Ebene durch stündliche Wurzel-Hash-Signaturen über ein internes Hardware Security Module nach BSI-Standards abgesichert.
Zweitens (Co-Managed): Unternehmen, die Nachweise gegenüber externen Regulierungsbehörden, Kunden oder Lieferanten erbringen müssen, betreiben die Transaktionsdatenbank intern, verankern die stündlich berechneten Merkle-Root-Hashes jedoch automatisiert bei einem akkreditierten Vertrauensdiensteanbieter (Qualified Trust Service Provider) mittels qualifizierter elektronischer Zeitstempel nach EU-Verordnung Nr. 910/2014 (eIDAS). Dadurch entsteht ein gerichtsverwertbarer Beweis durch eine unabhängige dritte Instanz zu minimalen Transaktionskosten von wenigen Cent pro Wurzel-Hash.
Drittens (Managed Service): Nur in jenen seltenen Ausnahmefällen, in denen ein branchenweites Konsortium ohne gemeinsamen Systembetreiber und ohne gegenseitiges Grundvertrauen gesetzlich oder marktseitig gezwungen ist, eine geteilte Zustandsmaschine zu betreiben, empfiehlt sich der Bezug einer verwalteten Permissioned-DLT-Plattform. Warum selbst namhafte Großprojekte an der Governance solcher Konsortien scheiterten, dokumentiert unsere Analyse der Enterprise-DLT-Fallstudien rund um TradeLens, B3i und we.trade.
Der 4-Phasen-Umsetzungsfahrplan: Vom Audit-Anforderungskatalog zum Merkle-gestützten Nachweissystem
Um revisionssichere Datenprotokolle nach den Anforderungen von GoBD, NIS-2 und BSI IT-Grundschutz ohne kostspielige DLT-Fehlinvestitionen einzuführen, hat sich in der Unternehmenspraxis ein strukturierter Implementierungsfahrplan über sechs bis zwölf Monate bewährt.
Phase 1 (Monat 1 bis 2): Bedrohungsmodellierung, DSGVO-Triage und Konsens-Prüfung
Zu Projektbeginn analysieren Enterprise-Architekten, Datenschutzbeauftragte und Wirtschaftsprüfer gemeinsam alle zu protokollierenden Geschäftsprozesse. Dabei wird formal geprüft, ob tatsächlich ein byzantinisches Bedrohungsmodell zwischen fremden Akteuren vorliegt oder ob ein Crash-Fault-Tolerant-Cluster ausreicht. Parallel werden sämtliche Datenfelder mit Personenbezug nach Artikel 17 DSGVO identifiziert und strikt von den zu hashenden Prüfmetadaten getrennt.
Phase 2 (Monat 3 bis 4): Aufbau des Append-Only-Schemas und der Merkle-Tree-Engine
In der zweiten Phase entwirft das Datenbankteam das relationale Schema in PostgreSQL mit strikter Trennung zwischen operativen Nutztabellen und dem unveränderbaren Audit-Log. Für die Audit-Tabelle werden UPDATE- und DELETE-Rechte selbst für reguläre Datenbankadministratoren über Row-Level-Security und Trigger unterbunden, während ein Hintergrunddienst die eingehenden Salted-SHA-256-Hashes kontinuierlich zu binären Merkle-Bäumen nach IETF RFC 6962 aggregiert.
Phase 3 (Monat 5 bis 6): HSM-Anbindung, eIDAS-Zeitstempelung und O(log n)-Prüf-API
Die periodisch berechneten Merkle-Root-Hashes werden nun an ein internes Hardware Security Module oder per REST-API an einen qualifizierten eIDAS-Zeitstempeldienst gekoppelt und auf einem unveränderbaren WORM-Speicher (S3 Object Lock im Compliance-Modus) abgelegt. Zusätzlich stellt das Team eine lesende Verifikations-API bereit, über die Revisoren zu jeder Buchungs-ID automatisiert den logarithmischen Merkle-Inclusion-Proof abrufen und unabhängig gegen den Zeitstempel prüfen können.
Phase 4 (Monat 7 bis 12): Produktive ERP-Kopplung, Lösch-Simulation und Wirtschaftsprüfer-Attest
Im letzten Schritt werden die produktiven ERP-, Finanz- und Lieferkettensysteme über asynchrone Event-Streams an das kryptografische Audit-Log angebunden, sodass im operativen OLTP-Betrieb keinerlei Latenzverluste entstehen. Vor der finalen Abnahme führt die interne Revision einen simulierten Manipulations- sowie einen DSGVO-Löschtest durch und lässt die Verfahrensdokumentation durch den Wirtschaftsprüfer nach IDW PS 880 bzw. GoBD testieren.
Fünf Kontrollfragen für Vorstand und IT-Leitung vor jedem Blockchain-Investment
1. Liegt zwischen den Systemteilnehmern tatsächlich ein byzantinisches Misstrauensverhältnis vor?
Prüfen Sie nüchtern, ob unbeteiligte Dritte ohne Vertragsbindung schreibend am Konsens teilnehmen sollen. Solange alle Knotenbetreiber über Rechtsverträge, Rahmenvereinbarungen und TLS-Client-Zertifikate bekannt und juristisch haftbar sind, bietet ein Raft-Cluster (Crash Fault Tolerance) tausendfach höhere Leistung bei minimaler Komplexität.
2. Warum reicht ein kryptografisches Append-Only-Log nach IETF RFC 6962 nicht aus?
Verlangen Sie von jedem Fachbereich oder Beratungsunternehmen, das eine Blockchain vorschlägt, eine schriftliche technische Begründung, welchen konkreten Mehrwert ein P2P-Konsensprotokoll gegenüber einem HSM-signierten Merkle-Tree-Log auf einer hochverfügbaren SQL-Datenbank liefert. In fast allen Audit-Szenarien ist allein die Merkle-Datenstruktur für die Beweiskraft verantwortlich.
3. Wie wird das Recht auf Löschung nach Artikel 17 DSGVO technisch und auditfest umgesetzt?
Genehmigen Sie niemals eine Architektur, die Klartextdaten, E-Mail-Adressen oder einfach gehashte Personenkennungen direkt in unveränderbare Blöcke schreibt. Bestehen Sie auf einer strikten Off-Chain-Datenhaltung in veränderlichen B-Tree-Tabellen, während im Merkle-Baum ausschließlich mit zufälligem Salt versehene Prüfsummen verankert werden.
4. Welche Auswirkungen haben O(n²)-Konsensrunden und State-Bloat auf die 5-Jahres-Infrastrukturplanung?
Lassen Sie sich vorab vorrechnen, wie stark das unbereinigte Ledger-Volumen (State Bloat) bei Millionen von Transaktionen pro Jahr auf jedem einzelnen Validierungsknoten anwächst und wie sich die Commit-Latenz verhält, wenn das Konsortium von fünf auf dreißig Teilnehmer skaliert. Ein Architekturvergleich mit unseren Kriterien unter Wo macht Blockchain Sinn? schützt vor teuren Skalierungssackgassen.
5. Wie hoch fällt die 60-Monats-TCO im direkten Vergleich zu einem bestehenden PostgreSQL-HA-Stack aus?
Stellen Sie den Gesamtkosten für spezialisierte Smart-Contract-Entwickler, externe Code-Audits und dedizierte Multi-Party-Serverknoten die Kosten einer Erweiterung Ihres bestehenden Enterprise-Datenbank-Stacks gegenüber. Wenn kein echter Mehrparteien-Dezentralisierungszwang existiert, verbrennt eine eigene DLT-Infrastruktur unnötig sechs- bis siebenstellige IT-Budgets.
Strategisches Fazit: Mathematische Präzision auf Datenbankebene schlägt verteilten Konsens-Overhead
Die sachliche Dekonstruktion der Blockchain-Architektur befreit IT-Entscheider aus einem jahrelangen Missverständnis. Die beeindruckende Fälschungssicherheit, die Wirtschaftsprüfer und Regulierungsbehörden zu Recht fordern, entstammt nicht dem langsamen und teuren Abgleich hunderter P2P-Serverknoten, sondern der eleganten Mathematik kryptografischer SHA-256-Hash-Ketten und binärer Merkle-Bäume.
Unternehmen, die diese kryptografischen Prüfstrukturen gezielt aus dem DLT-Korsett herauslösen und als schlanke Append-Only-Logs mit logarithmischen O(log n)-Prüfpfaden direkt in ihre hochverfügbaren PostgreSQL-Cluster integrieren, erhalten das Beste aus beiden Welten. Sie sichern sich lückenlose Revisions- und DSGVO-Konformität bei Millisekunden-Latenz und senken ihre Gesamtkosten über fünf Jahre um mehr als 80 Prozent.
Häufig gestellte Fragen (FAQ) zu Blockchain-Architekturen im Konzern-Audit
Worin liegt der genaue technische Unterschied zwischen einem Merkle Tree und einer Blockchain?
Ein Merkle Tree ist eine binäre Baum-Datenstruktur aus kryptografischen Hashwerten, die es erlaubt, die Integrität einzelner Datensätze über einen logarithmischen Prüfpfad O(log n) gegen einen einzigen Wurzel-Hash (Merkle Root) zu beweisen. Eine Blockchain nutzt Merkle Trees lediglich als interne Komponente pro Block und ergänzt sie um eine chronologische Header-Verkettung sowie ein verteiltes Netzwerk-Konsensprotokoll.
Warum skaliert ein Raft-Cluster im Rechenzentrum wesentlich besser als ein BFT-Blockchain-Konsens?
Das Crash-Fault-Tolerant-Protokoll Raft geht davon aus, dass Knoten zwar ausfallen können, aber keine böswillig gefälschten Nachrichten senden; dadurch repliziert der Leader-Knoten Daten linear mit O(n) in wenigen Millisekunden. Byzantinische Konsensprotokolle (PBFT) müssen hingegen aktiv manipulierende Knoten überstimmen, was mehrstufige Abstimmungsrunden mit quadratischer Nachrichtenkomplexität O(n²) erzwingt.
Wie lässt sich die Unveränderbarkeit eines Merkle-Logs mit dem Löschrecht nach Artikel 17 DSGVO vereinen?
Durch konsequentes Off-Chain-Payload-Referencing: Personenbezogene Klartextdaten werden ausschließlich in regulären relationalen Datenbanktabellen gespeichert, während nur ein mit einem datensatzspezifischen Zufallswert (Salt) berechneter SHA-256-Hash in den Merkle-Baum einfließt. Bei einer Löschanfrage werden Klartext und Salt in der Datenbank physisch gelöscht, wodurch der verbleibende Hash im Log jeden Personenbezug verliert.
Kann ein Datenbankadministrator ein lokales Append-Only-Log nicht einfach samt den Hashwerten neu berechnen?
Nein, sofern die berechneten Merkle-Root-Hashes periodisch (etwa stündlich) außerhalb der Einflussnahme des Administrators verankert werden. Dies geschieht durch die Signatur in einem manipulationsgeschützten Hardware Security Module (HSM), die Ablage auf einem WORM-Speicher (Object Lock) oder die Einholung eines qualifizierten elektronischen Zeitstempels nach der europäischen eIDAS-Verordnung.
In welchem konkreten Ausnahmefall ist eine Permissioned Blockchain im B2B-Umfeld dennoch sinnvoll?
Ein verteiltes Ledger mit BFT-Konsens ist genau dann technisch begründet, wenn mehrere wirtschaftlich und juristisch unabhängige Organisationen eine gemeinsame Geschäftslogik (State Machine) ausführen müssen, sich jedoch aus Wettbewerbs- oder Kartellgründen auf keinen gemeinsamen zentralen Plattformbetreiber oder Treuhänder einigen können.
Auditierbare Primärquellen & Technische Referenzen
| Institution & Herausgeber | Primärquelle & Normdokument | Architektonische Relevanz für den CIO |
|---|---|---|
| Internet Engineering Task Force (IETF) | IETF RFC 6962 (Merkle Hash Trees & Certificate Transparency) ↗ | Normative Referenz für kryptografische Append-Only-Logs, binäre Merkle-Bäume und logarithmische O(log n)-Inclusion-Proofs ohne Blockchain-Overhead. |
| PostgreSQL Global Development Group | PostgreSQL Documentation (MVCC, WAL & B-Tree Indexing) ↗ | Technische Spezifikation für transaktionale ACID-Datenhaltung, Write-Ahead-Logging und veränderliche B-Tree-Speicherstrukturen im Enterprise-Betrieb. |
| Bundesamt für Sicherheit in der Informationstechnik (BSI) | BSI IT-Grundschutz-Kompendium (Baustein CON.1 Kryptokonzept) ↗ | Verbindliche Vorgaben für kollisionsresistente Hashfunktionen (SHA-256/SHA-3), Schlüssellängen und sicheres Schlüsselmanagement im Konzern-Audit. |
| Europäische Union (Amtsblatt EUR-Lex) | Verordnung (EU) 2016/679 (DSGVO Art. 17 Recht auf Löschung) ↗ | Gesetzliche Grundlage für die Pflicht zur Off-Chain-Speicherung personenbezogener Daten und die Unzulässigkeit unveränderbarer On-Chain-Klartexte. |
| Europäische Union (Amtsblatt EUR-Lex) | Richtlinie (EU) 2022/2555 (NIS-2 Art. 21 Kryptografie & Audit) ↗ | Regulatorische Nachweispflichten für den Einsatz kryptografischer Verfahren, manipulierungsgeschützter Protokollierung und Lieferketten-Governance. |
*Modellrechnung: Alle angegebenen Lizenz-, Infrastruktur- und TCO-Werte verstehen sich als unverbindliche Beispielkalkulation auf Basis typischer Szenarien.
**Verweise auf Gesetzestexte, Paragrafen (u. a. DSGVO, NIS-2, EU AI Act, DORA, GoBD, BetrVG) und Compliance-Normen dienen ausschließlich der unverbindlichen technischen Fachinformation für IT-Entscheider. Sie stellen keine Rechtsberatung nach dem Rechtsdienstleistungsgesetz (RDG) dar; für eine rechtsverbindliche Beurteilung Ihrer spezifischen Unternehmensorganisation konsultieren Sie bitte Ihren Rechtsbeistand oder Datenschutzbeauftragten.

DAS CxO-PARADOX
Wie falsche digitale Souveränität Wirtschaft und Staat entkernt und wie echte Unabhängigkeit gelingt.
Von Mathias Diwo · Executive Tech Advisor
- ✓ 6-Hebel-Plan: Geordneter Ausstieg aus VMware- & Hyperscaler-Lock-ins
- ✓ Board Scorecard: One-Page IT-Governance für Vorstand & Aufsichtsrat
- ✓ Sofort lesbar: Vollständiges Kapitel 1 als Vorab-Dossier
Strategische Vertiefung im gleichen Themencluster
Weiterführende Architektur- und Handlungsleitfäden für CIOs & IT-Entscheider.

Cilium eBPF & Kubernetes Security: Leitfaden für Zero-Trust-Microsegmentierung
Klassische iptables-Filter und Sidecar-Service-Meshes bremsen große Kubernetes-Cluster massiv aus. Dieser Leitfaden zeigt, wie Cilium und eBPF im Linux-Kernel O(1)-Routing, Layer-7-Zero-Trust, Tetragon-Laufzeitschutz und WireGuard-Verschlüsselung vereinen.

Keycloak und Authentik im Enterprise-IAM: Leitfaden für Zero Trust und Entra-ID-Exit
Proprietäre Identitätsdienste wie Microsoft Entra ID und Okta koppeln elementare Sicherheitsfunktionen wie Conditional Access und FIDO2-Passkeys an kostspielige P1- und P2-Aufpreise. Dieser Leitfaden analysiert die Architektur von Keycloak und Authentik und zeigt den strukturierten Weg zur souveränen Zero-Trust-Identitätsföderation.

Mathias Diwo
Herausgeber & Executive Tech AdvisorGründer von TechNavigator.de, Buchautor (HYBRID WORK) und strategischer Beirat für CIOs und Vorstände. Begleitet mittelständische Konzerne und Verwaltungsorganisationen bei Cloud-Exit-Strategien, NIS-2 Haftungsschutz und digitaler Souveränität.